数据结构-线性表(2)
数据结构-线性表(2)
4FGR2.1 线性表的定义和基本操作
定义
线性表是有相同数据类型的 \(n\) 个数据元素的有限序列,\(n\) 为表长,\(n=0\) 时线性表是一个空表。若用 \(L\) 命名线性表,可表示为 \[ L=(a_1,a_2,\cdots,a_i,a_{i+1},\cdots,a_n) \] 其中,第一个元素 \(a_1\) 为表头元素,最后一个元素 \(a_n\) 是表尾元素,除第一个元素外,每个元素有且仅有一个直接前驱;除最后一个元素外,每个元素有且仅有一个直接后继。
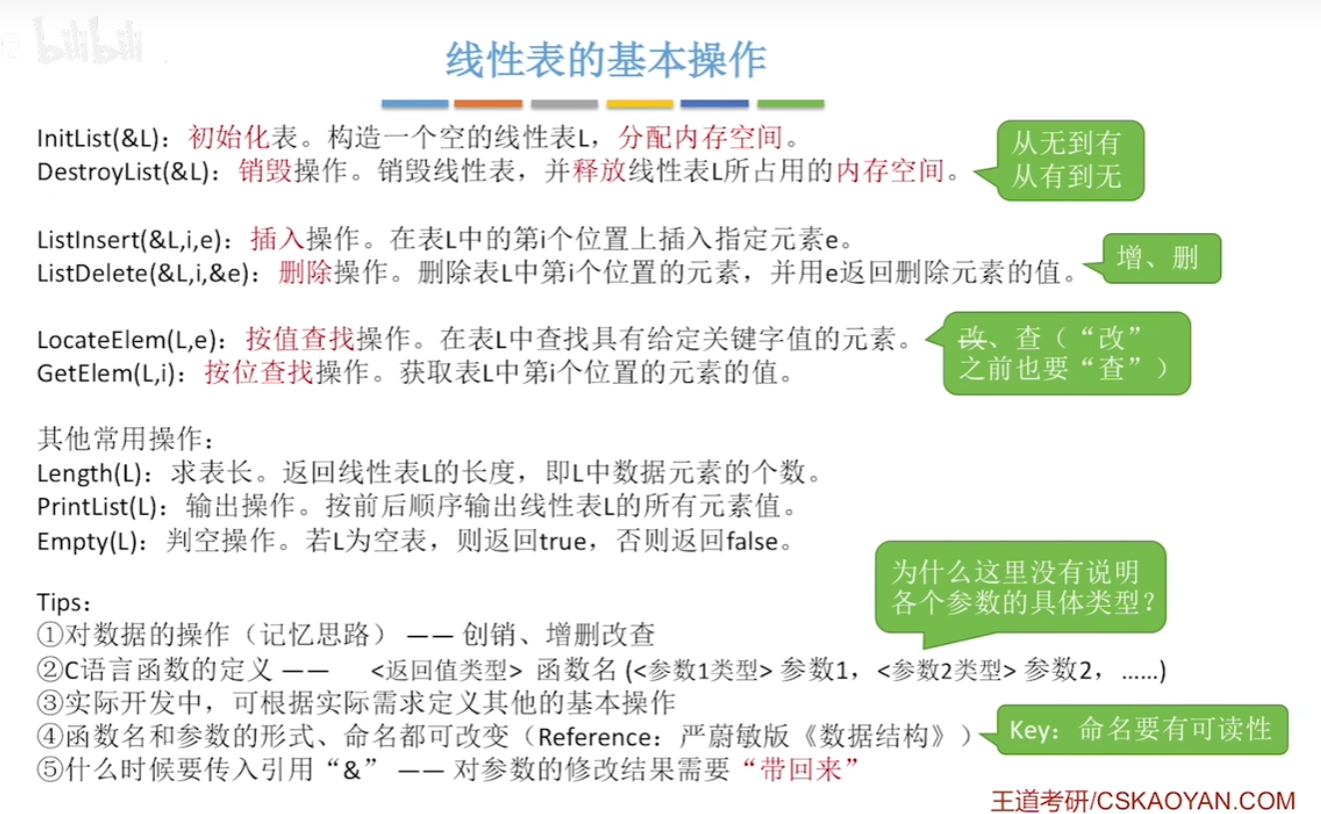
基本操作
2.2 线性表的顺序表示
顺序表的定义
用顺序存储方式实现线性表,称这样的表为顺序表。
- 用一个组地址连续的存储单元依次存储线性表中的数据元素。
- 逻辑上相邻的元素在物理位置上也相邻,逻辑顺序和物理存储顺序完全一致
定义
静态分配
1 |
|
动态分配
1 |
|
顺序表上的基本操作的实现
1.顺序表的初始化
静态
1 | void InitList(SqList &L){ |
动态
1 | void InitList(SeqList &L){ |
2.插入操作
1 | bool ListInsert(SqList &L,int i,ElemType e){ |
最好情况 \(O(1)\) ,最坏 \(O(n)\) ,平均时间复杂度为 \(O(n)\) 。
3.删除操作
1 | bool ListDelete(SqList &L,int i,ElemType &e){ |
最好情况 \(O(1)\) ,最坏 \(O(n)\) ,平均时间复杂度为 \(O(n)\) 。
4.按值查找
1 | int LocateElem(SqList L,ElemType e){ |
2.3 线性表的链式表示
顺序表支持随机存储,但插入和删除操作开销大,效率较低。链式存储的线性表不能实现随机存取,但插入或删除操作只需修改指针,效率较高。
单链表的定义
用链式存储方式实现线性表,称这样的表为单链表。
1 | typedef struct LNode{ |
通常使用头指针 \(L\) (或 \(head\) ) 来标识一个单链表。头指针为 \(NULL\) ,表示链表为空。此外,为了简化操作,单链表的第一个数据节点之前常附加一个特殊的结点,称为头结点。头节点的数据域一般不放有效数据(但可用于记录表长等信息)。在带头结点的单链表中,头指针 \(L\) 指向头节点,而头节点的 \(next\) 指向第一个数据结点。若不带头节点,则头指针指向第一个数据结点。
引入头结点的好处
- 操作统一性:使得第一个数据结点的操作与其他位置的操作逻辑一致
- 空表与非空表处理统一: 头指针始终非空,只用判断头结点的 \(next\) 是否为空即可。
单链表上基本操作的实现
1.单链表的初始化
带头节点
1 | bool InitList(LinkList &L){ |
不带头结点
1 | bool InitList(LinkList &L){ |
2.求表长操作
1 | int Length(LinkedList L){ |
3.按序号查找结点
1 | LNode *GetElem(LinkedList L,int i){ |
4.按值查找结点
1 | LNode *LocateElem(LinkList L,ElemType e){ |
5.插入结点操作
不用担心插入的下一个结点为空,\(p\) 的 \(next\) 赋值给 \(s\) 的 \(next\) ,结果仍为空,删除同理。
1 | bool ListInsert(LinkList &L,int i,ElemType e){ |
若需要对某个结点 \(p\) 进行前插,相当于后插后交换元素值。
1 | s->next = p->next; |
6.删除结点操作
1 | bool ListDelete(LinkList &L,int i,ElemType &e){ |
7.采用头插法建立单链表
将新节点插入头结点后面,称为头插法,链表顺序和输入顺序相反。
1 | LinkList List_HeadInsert(LinkList &L){ // 头插法建表 |
8.采用尾插法建立单链表
维护尾指针 \(r\) ,始终指向当前链表的尾结点,新结点插入到 \(r\) 的指针域,并更新 \(r\) 。
1 | LinkList List_TailInsert(LinkList &L){ |
双链表
单链表只包含后继结点的指针,双链表引入了前驱结点的指针 \(prior\) 。其中,头结点的 \(prior\) 为 \(NULL\) ,尾结点的 \(next\) 也为 \(NULL\) 。
1 | typedef struct Dnode{ |
1.双链表的插入操作
在 *p 之后插入节点 *s
1 | s->next = p->next; // 1.将节点插入 p 之后 |
其中 \(1,2\) 得在 \(3\) 之前,避免 p->next 被覆盖,对于 \(2\) ,采用 s->next->prior 则不必。
2.双链表的删除操作
在 *p 之后删除节点 *s
1 | p->next = s->next; |
循环链表
循环单链表
相比于单链表,最后一个结点*r的指针域不再是 \(NULL\) ,而是指向头结点,从而使链表成为一个环,因此插入或删除在任何位置上都是等价的,无需判断是否在表尾。
- 判空:L->next == L
- 遍历结束:p->next==L
为提高效率,有时不设头指针,而仅设置尾指针 \(r\) 。若仅使用头指针,则表尾插入需要遍历整个链表。
例如,在表尾插入结点*s时,需要令 s->next = r->next (指向头结点),r->next = s (更新原尾结点后继),r = s (更新尾结点)
循环双链表
相比于双链表,头结点的前驱应该是尾结点,尾结点的后继应该是头结点。
- 判空:L->prior==L 且 L->next==L
- 遍历结束:回到出发结点 \(p\) 比如 i->next = L
静态链表
用数组模拟链表。
1 |
|
静态链表以 next==-1 作为其结束标志。
顺序表和链表的比较
| 线性表 | 存取(读写)方式 | 逻辑结构与物理结构 | 查、插、删操作 | 空间分配 |
|---|---|---|---|---|
| 顺序表 | 支持随机存取 | 逻辑上相邻,物理上也相邻,物理内存连续 | \(O(n)\) | 静态需要预先分配,过大容易浪费,过小容易溢出。动态分配耗时且可能因为连续空间不够而失败 |
| 链表 | 仅支持顺序存取 | 逻辑相邻的元素物理上未必相邻,逻辑关系通过指针显式维护 | \(O(n)\) | 动态分配,按需扩展,但存储密度小于 \(1\) ,空间利用率较低。 |
其中查找为按值查找,有序下,顺序表为 \(O(\log n)\) ,按序号查找下,顺序表为 \(O(1)\) 。
对于规模稳定、以随机访问为主的场景,宜采用顺序存储;而动态性强、频繁插删的场景,则更适合链式存储。