数据结构-树(5)
数据结构-树(5)
4FGR参考资料:
2027王道数据结构
5.1 树的基本概念
考研中及王道书的树默认为有根树,下面的树均按此定义,为方便考研,所有树的定义名称按王道书来。
会有拓展的补充。
定义
树时 \(n (n\geq 0)\) 个结点的有限集。\(n=0\) 的树称为空树。非空树需满足
- 有且仅有一个根结点
- 当 \(n>1\) 时,其余结点可分为 \(m\) 个互不相交的有限集 \(T_1,T_2,\cdots,T_m\) ,其中每个集合本身又是一棵树,称为根的子树。
显然,树的定义是递归的,树是一种典型的递归数据结构。
有关树的定义
- 森林 (forest) :每个连通分量(连通块)都是树的图。按照定义,一棵树也是森林。
- 生成树 (spanning tree) :一个连通无向图的生成子图,同时要求是树。也即在图的边集中选择 \(n-1\) 条,将所有顶点连通。
- 双亲(父结点):向上一层的与之连接的节点,即到根节点的路径上的第二个节点,显然根节点无父亲。
- 祖先:到根节点路径上的所有结点(不包括自己)
- 孩子(子结点)):如果 \(u\) 是 \(v\) 父亲,则 \(v\) 是 \(u\) 的孩子(子结点)
- 结点的层次(深度) :到根节点的路径上的边数
- 树的高度(深度):所有结点的深度的最大值
- 兄弟:同一个父亲的多个子节点互为兄弟
- 堂兄弟 :双亲位于同一层的结点
- 子孙:子结点及其子结点的子孙
- 子树:以子结点为根的树(无视与其父亲的边)
- 结点的度:结点的孩子个数。
- 树的度 :树中所有结点的度的最大值
- 叶结点:度为 \(0\) 的结点,也称终端结点
- 分支结点:度大于等于 \(0\) 的结点
树的性质
树的结点数 \(n\) 等于所有结点的度数之和加 \(1\)
度为 \(m\) 的树中,第 \(i\) 层至多有 \(m^{i-1}\) 个结点(\(i\geq 1\))
高度为 \(h\) 的 \(m\) 叉树,至多有 \(\frac{m^h-1}{m-1}\) 个结点
具有 \(n\) 个结点的 \(m\) 叉树的最小高度为 \(\lceil \log_m(n(m - 1) + 1) \rceil\)
度为 \(m\) 、具有 \(n\) 个结点的树的最大高度为 \(n-m+1\)
5.2 二叉树的概念
二叉树,其核心特征在于:每个结点至多拥有两棵子树,也就是树的度不超过为 \(2\) ,且子树间有次序。
二叉树是包含 \(n\) 个结点的有限集合:
- 或者为空二叉树
- 或者由一个根结点和两棵互不相交的被称为根的左子树和右子树构成,且左右子树本身也均为二叉树。
二叉树属于有序树 ,左右子树交换,就不是原来的那棵树了。
特殊的二叉树
- 完全二叉树(complete binary tree):只有最下面两层结点的度数可以小于 \(2\),且最下面一层的结点都集中在该层最左边的连续位置上的二叉树。
- 完美二叉树/满二叉树(perfect binary tree):所有叶结点的深度均相同,且所有非叶结点的子结点数量均为 \(2\) 的二叉树。
- 二叉排序树:左子树上所有结点的关键字小于根节点的关键字;右子树上所有结点的关键字大于根节点的关键字。且左右子树也都是二叉排序树。
- 平衡二叉树:树中任意一个结点的左子树和右子树的高度之差的绝对值不超过 \(1\)
- 正则二叉树:每个结点的子结点数量要么为 \(0\) 要么为 \(2\) 。即要么结点是叶子,要么结点左右子树非空
二叉树的性质
非空二叉树的叶结点数等于度为 \(2\) 的结点数加 \(1\) ,即 \(n_0=n_2+1\)
非空二叉树的第 \(k\) 层最多有 \(2^{k-1}\) 个结点
高度为 \(h\) 的二叉树至多右 \(2^h-1\) 个结点
对完全二叉树按从上到下、从左到右的顺序依次编号 \(1,2,\cdots,n\) ,则有一下关系
①最后一个分支结点的编号为 \(\lfloor n/2 \rfloor\) ,若 \(i\leq \lfloor n/2 \rfloor\) ,则结点 \(i\) 为分支结点,否则为叶节点
②叶节点只可能出现在最后两层上
③若存在度为 \(1\) 的结点,则最多只可能有一个,且该结点只有左孩子而无右孩子
④按层序编号后,第一个叶结点或仅有左孩子的结点 \(i\) 之后,均为叶节点。
⑤若 \(n\) 为奇数,则每个分支节点都有左右孩子;若 \(n\) 为偶数,则最后一个分支结点只有左孩子
⑥当 \(i>1\) 时,结点 \(i\) 的双亲结点的编号为 \(\lfloor i/2 \rfloor\)
⑦若结点 \(i\) 有左右孩子,则左孩子编号为 \(2i\) ,右孩子为 \(2i+1\)
⑧结点 \(i\) 所在层次(深度)为 \(\lfloor \log_2{i}\rfloor+1\)
具有 \(n\) 个结点的完全二叉树的高度为 \(\lceil \log_2{(n+1)\rceil}\) (\(\lfloor\log_2{n}\rfloor+1\))
二叉树的存储结构
1.顺序存储结构
用数组存取,顺序按照自上而下、自左向右的层序,依次存储,其中完全二叉树和满二叉树特别适合顺序存储,否则需要插入空结点,空间效率低。
2.链式存储结构
二叉树通常采用链式存储,在含有 \(n\) 个结点的二叉链表中,共有 \(n+1\) 个空链域 ,因此后面会有利用空链域构造一种新的链表结构——线索链表
1 | typedef struct{ |
5.3 二叉树的遍历和线索二叉树
二叉树遍历
1.先序遍历
输出在调用递归之前,即按照 根,左,右 的顺序遍历。
2.中序遍历
输出在调用左子树递归之后,即按照 左,根,右 的顺序遍历。
3.后续遍历
输出在调用递归之后,即按照 左,右,根 的顺序遍历二叉树
可根据中序遍历序列和另一个遍历序列求第三个序列
前序:第一个是root
后序:最后一个是root
中序:root两旁是左右子树
1 | void PreOrder(BiTree T){ |
4.层序遍历
需要借助一个队列
1 | void LevelOrder(BiTree T){ |
5.由遍历序列构造二叉树
得知中序序列,知道另外三种遍历序列的任意一种,都可以唯一地重构出该二叉树。
1.由先序序列和中序序列构造
先序序列的第一个结点是二叉树的根,找到中序序列的对应位置,左边的都是左子树的中序序列,右边是右子树的中序序列,再从先序序列中剥离出左右子树的先序序列,然后递归进行即可。
2.由后序序列和中序序列构造
后序序列的最后一个结点是二叉树的根,构造方法与上述同理。
3.由层序序列和中序序列构造
层序序列的第一个结点是二叉树的根,紧接着的两个结点分别为左右子树的根,根据中序序列划分左右子树的中序序列,递归划分即可。
线索二叉树
之前的链式存储二叉树,\(n\) 个结点会有 \(n+1\) 的空指针域,每个叶节点贡献两个空指针,每个度为 \(1\) 的节点贡献一个空指针。线索二叉树的思想是,利用这些空指针,直接指向节点在遍历序列中的前驱或后继,具体规定
- 若某节点无左子树,则将 \(lchild\) 指向其在指定遍历序列中的前驱节点。
- 若某节点无右子树,则将 \(rchild\) 指向其在指定遍历序列中的后继节点。
线索二叉树的存储结构可定义:
1 | typedef struct ThreadNode{ |
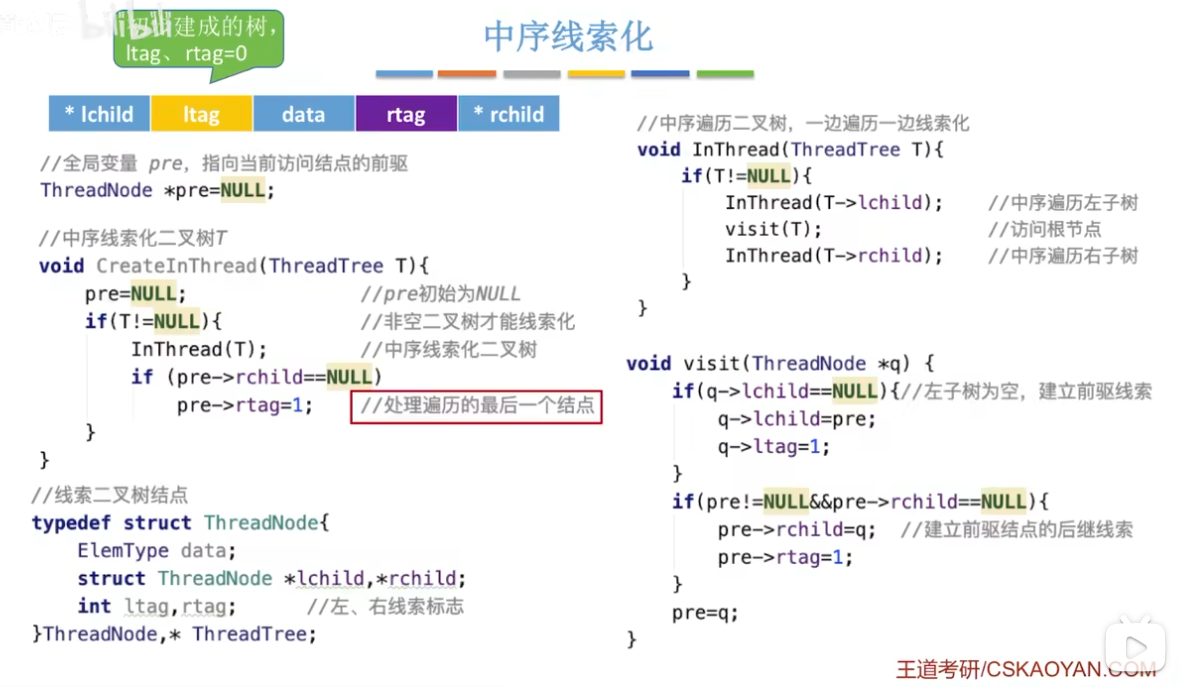
中序线索二叉树的构造
按中序序列划分前驱和后继(对应元素在中序序列中的前后元素)。
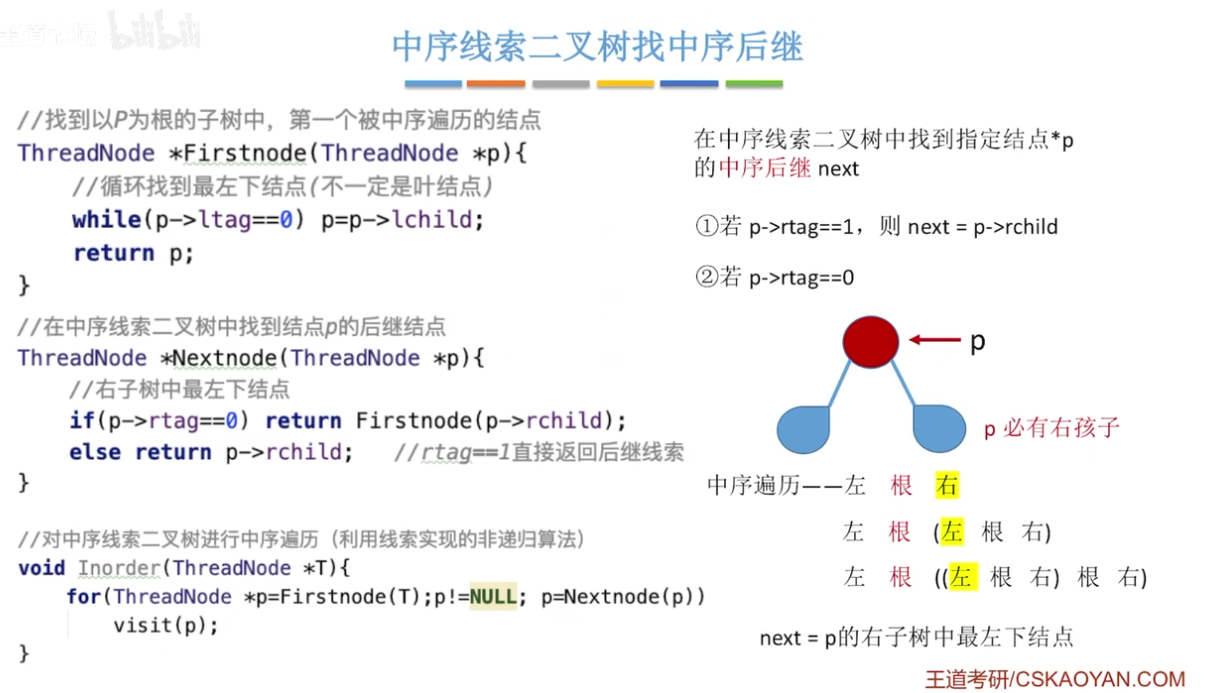
中序线索二叉树的遍历
5.4 树、森林
树的存储结构
1.双亲表示法
这种办法用一组连续的存储空间(如数组)来存放结点。
1 |
|
查找双亲十分高效,但查找孩子需要遍历整个树,效率较低。
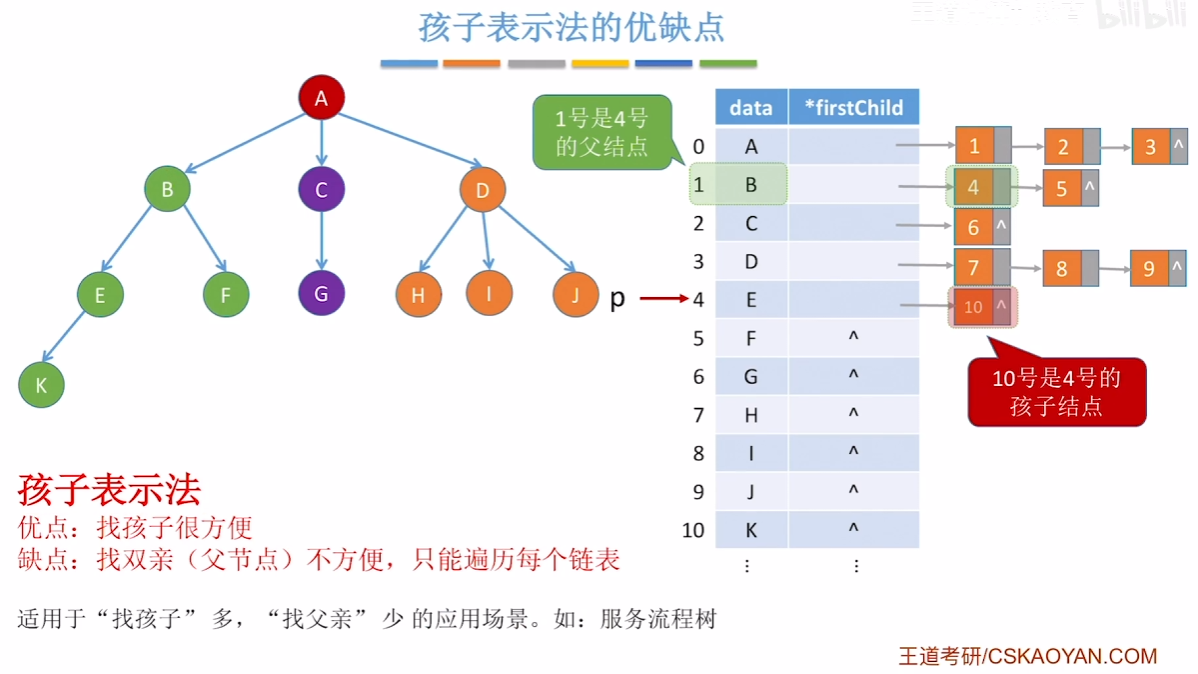
2.孩子表示法
将每个结点的所有孩子视作一个线性表,并用单链表存储。
找孩子方便,但找父节点不方便。
存储森林时,需要定义结构体存放所有根
3.孩子兄弟表示法
1 | typedef struct CSNode{ |
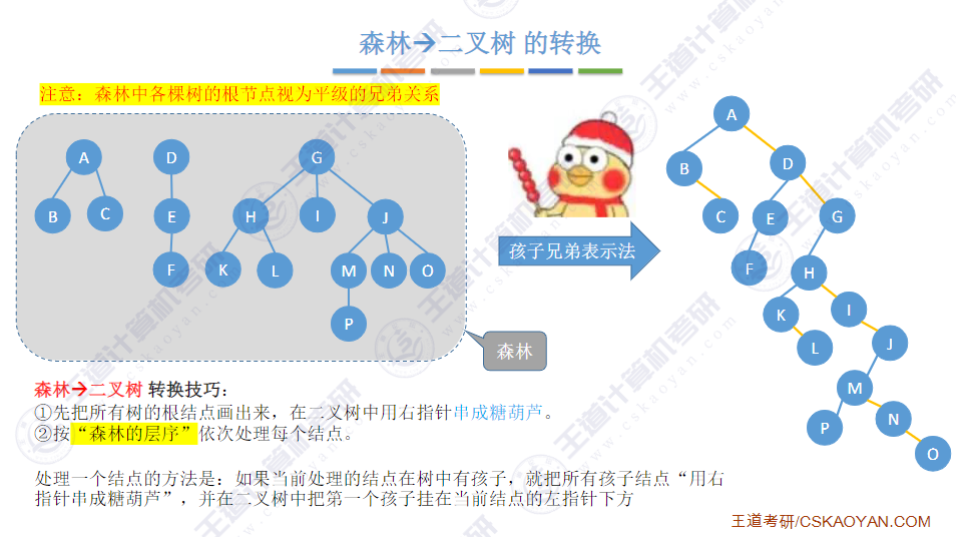
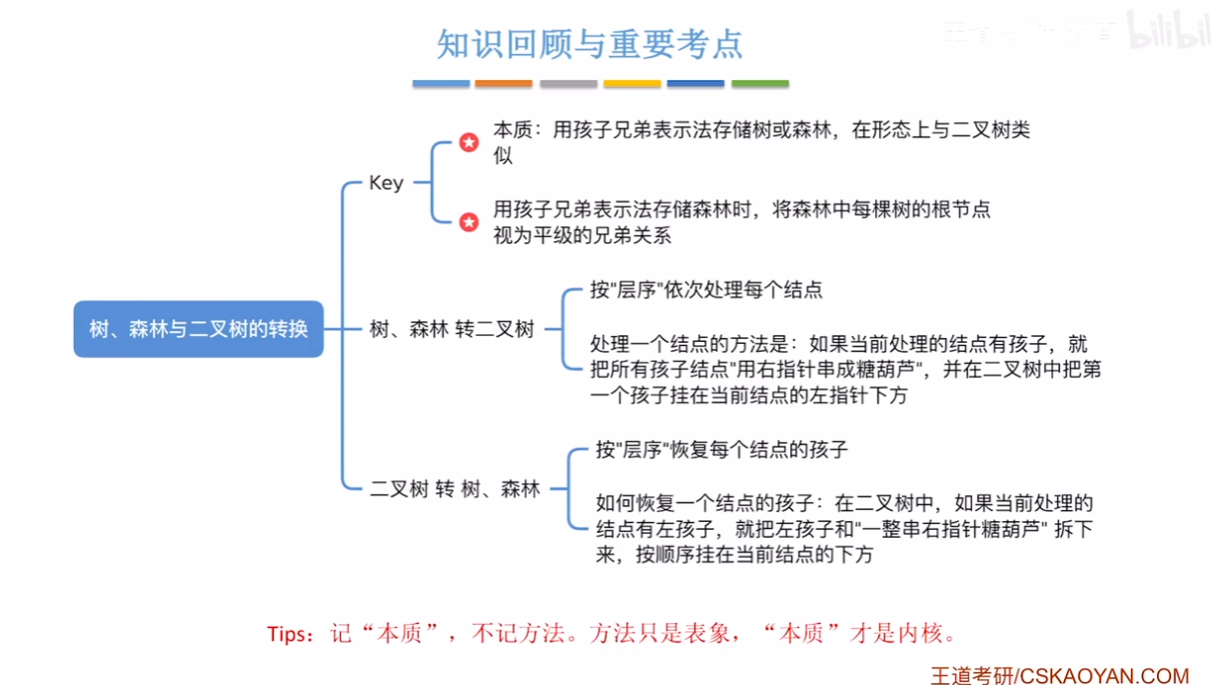
存储森林时,将森林中每棵树的根节点视为平级的兄弟关系
最大的优点是,能自然地将树转换成二叉树
如需要回溯到双亲,最好再增加一个指针域。
树、森林与二叉树的转换
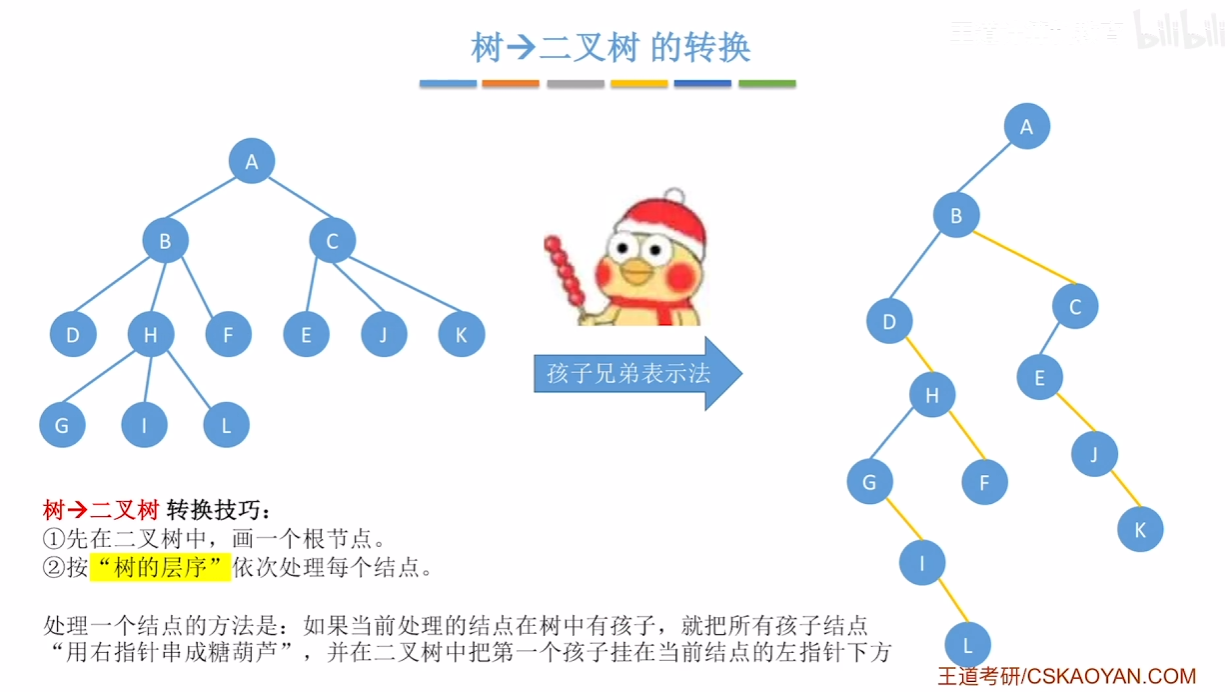
1.树转二叉树
按孩子兄弟表示法:
2.森林转二叉树
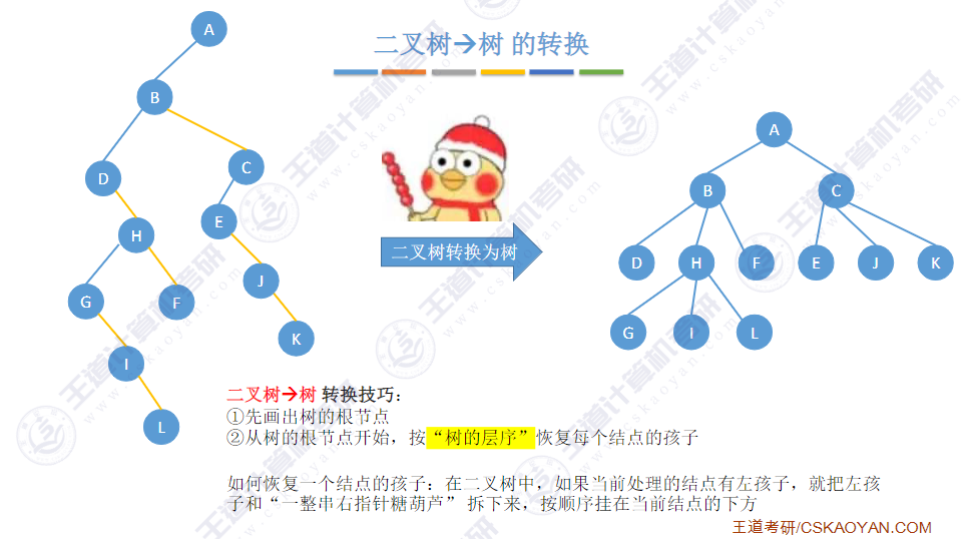
3.二叉树转树
转成森林时,只用将根节点的右链(一整串右边的孩子)全部变成对应的根结点即可。
树、森林的遍历
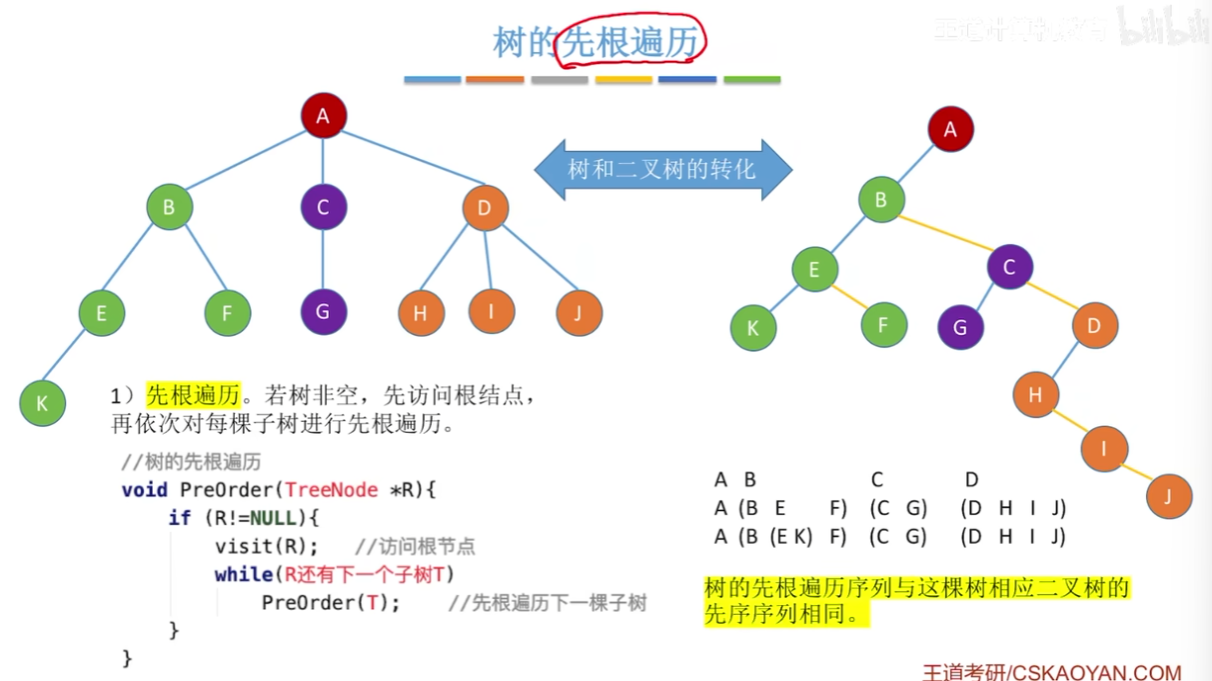
先根遍历(深度优先)
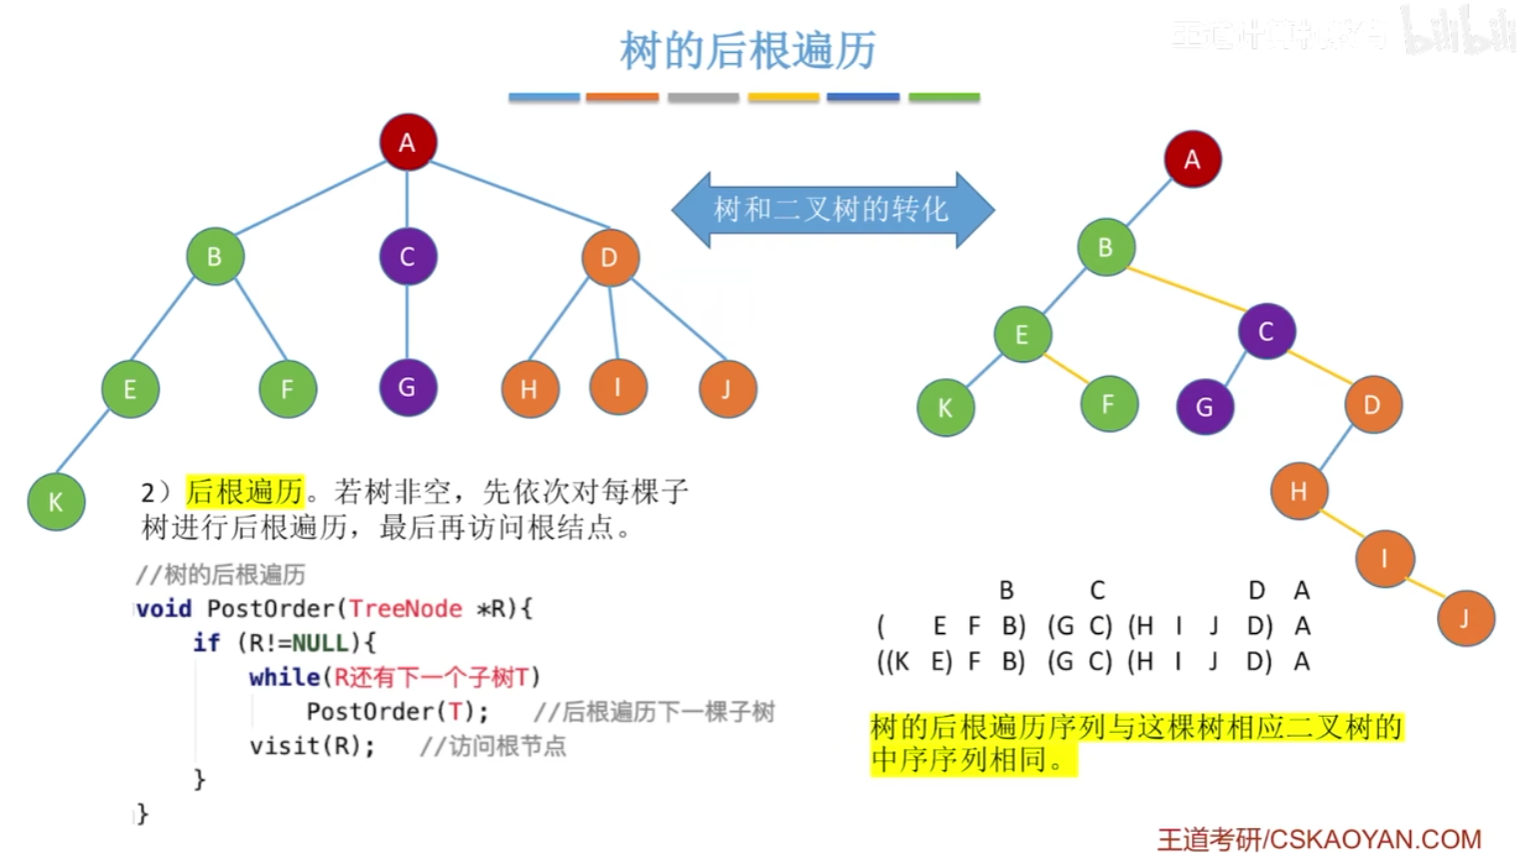
后根遍历(深度优先)
层序遍历(广度优先)
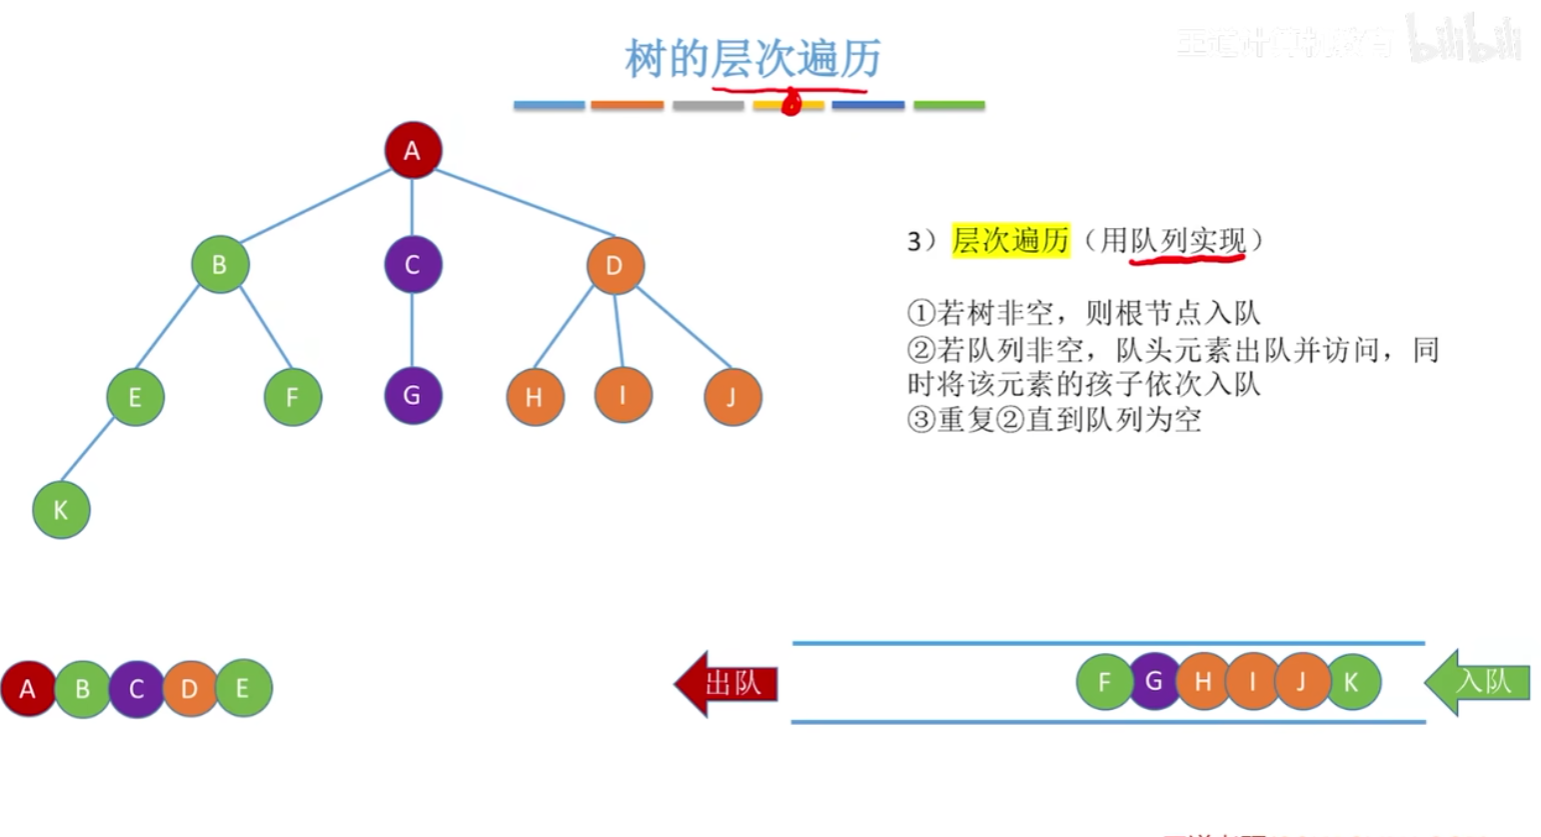
森林的先序遍历,等同于对各个子树进行先序遍历。
森林的中序遍历,等同于对各个子树进行后根遍历。
也等同于转成二叉树,进行对应的遍历。
5.5 树与二叉树的应用
哈夫曼树
带权路径长度:从树的根到该结点的路径长度与该结点权值的乘积
在含有 \(n\) 个带权叶结点的二叉树中,其中带权路径长度(WPL)最小的二叉树称为哈夫曼树,也称最优二叉树。
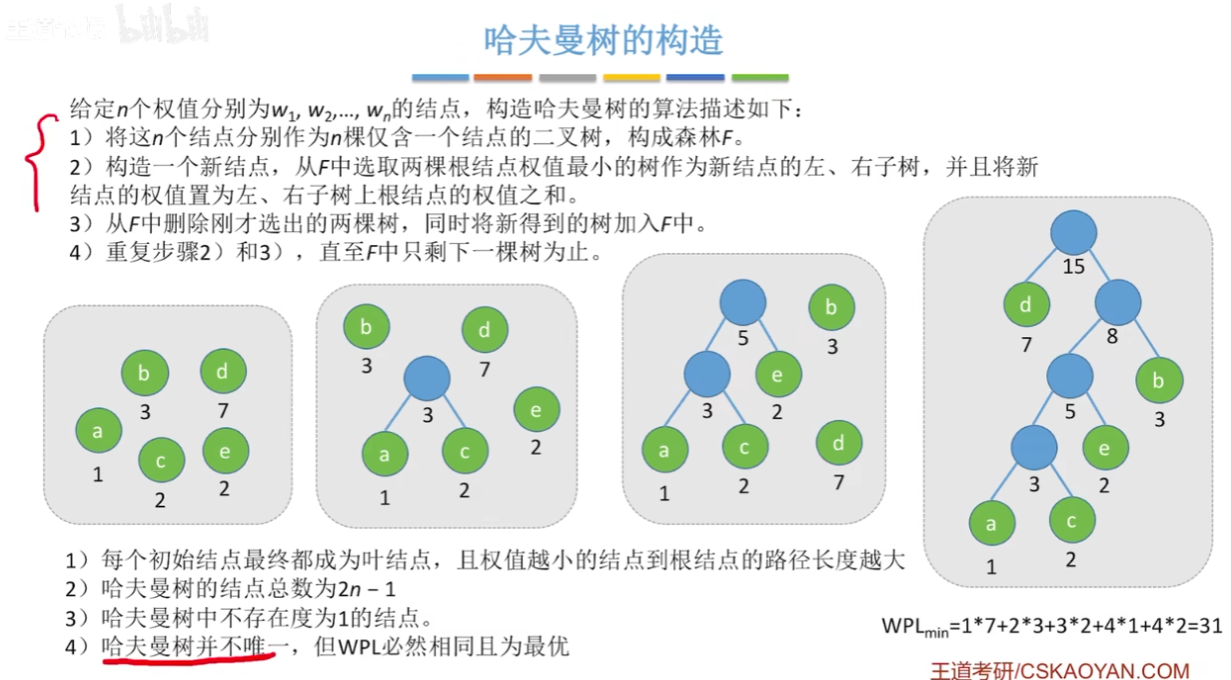
哈夫曼编码
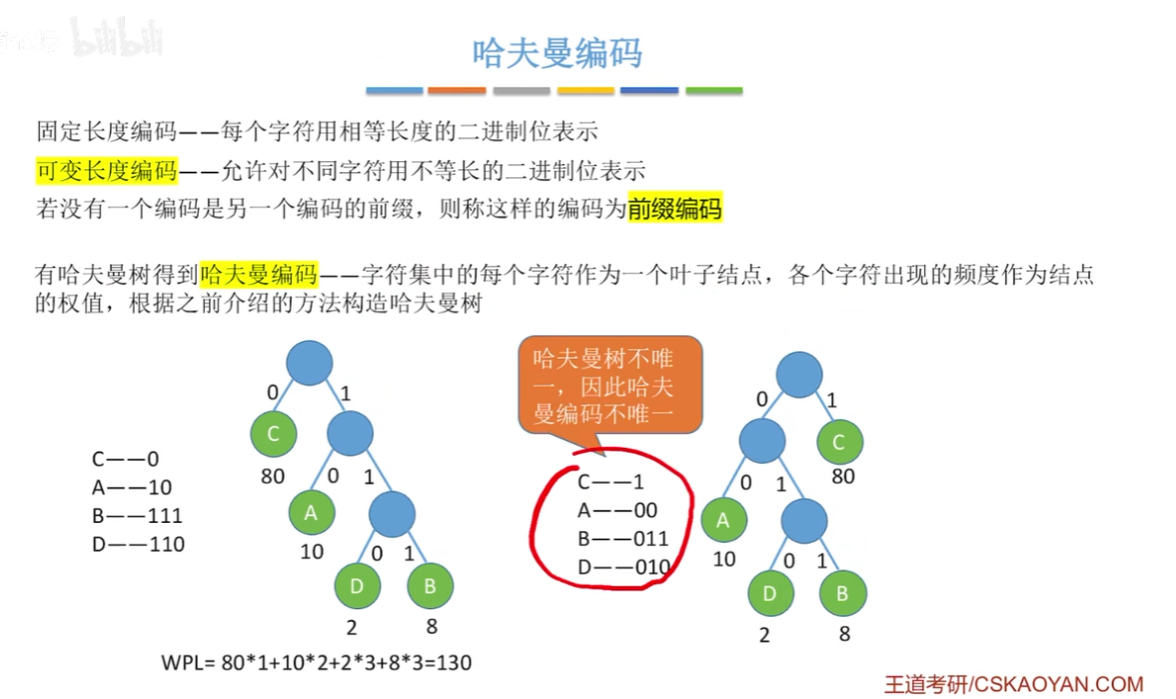
并查集
这里按王道书的来,还有用x=s[x]判断根的方法比较普遍,可见博客中的数据结构-并查集
并查集是处理不相交集合的合并与查询问题的树状数据结构
定义
1 |
|
初始化
1 | void Initial(int S[]){ |
查询
1 | // 可以这样做 |
合并
1 | //按集合大小 |