数据结构-图(6)
数据结构-图(6)
4FGR6.1 图的基本概念
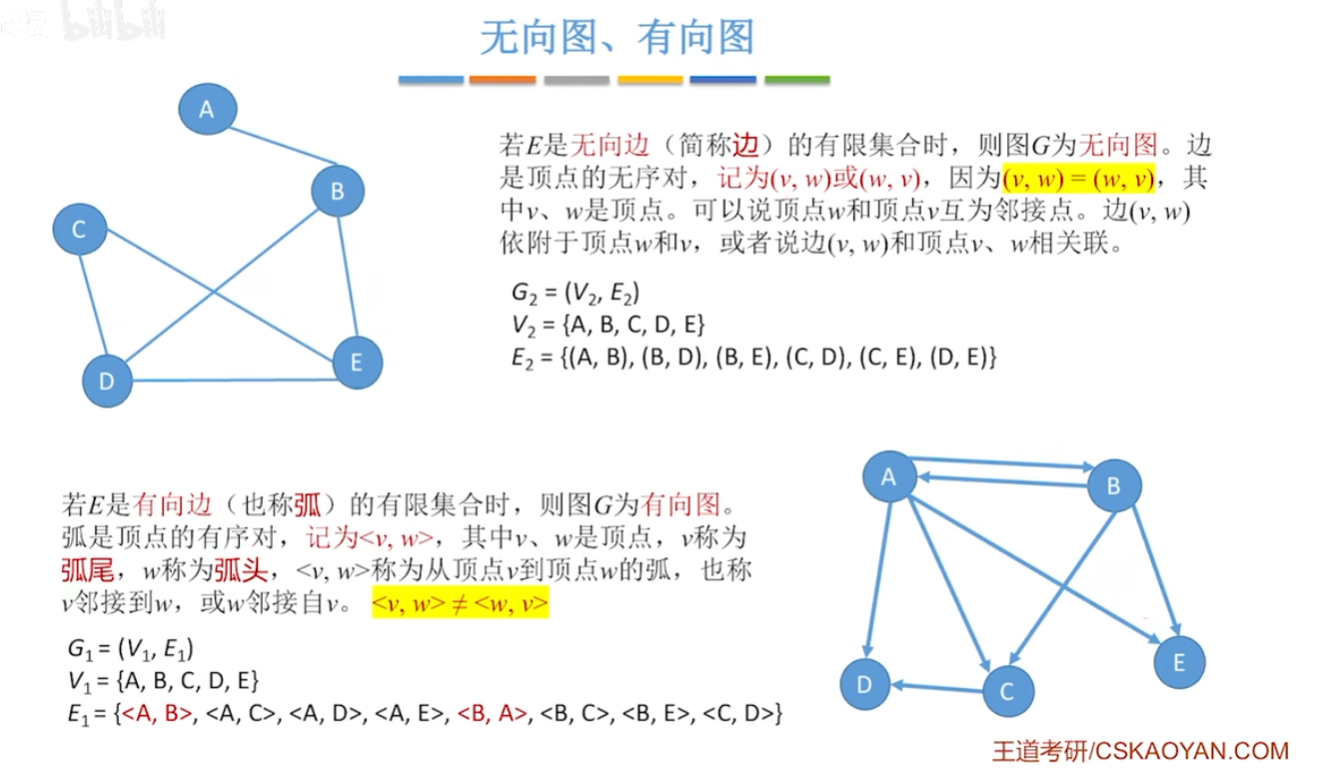
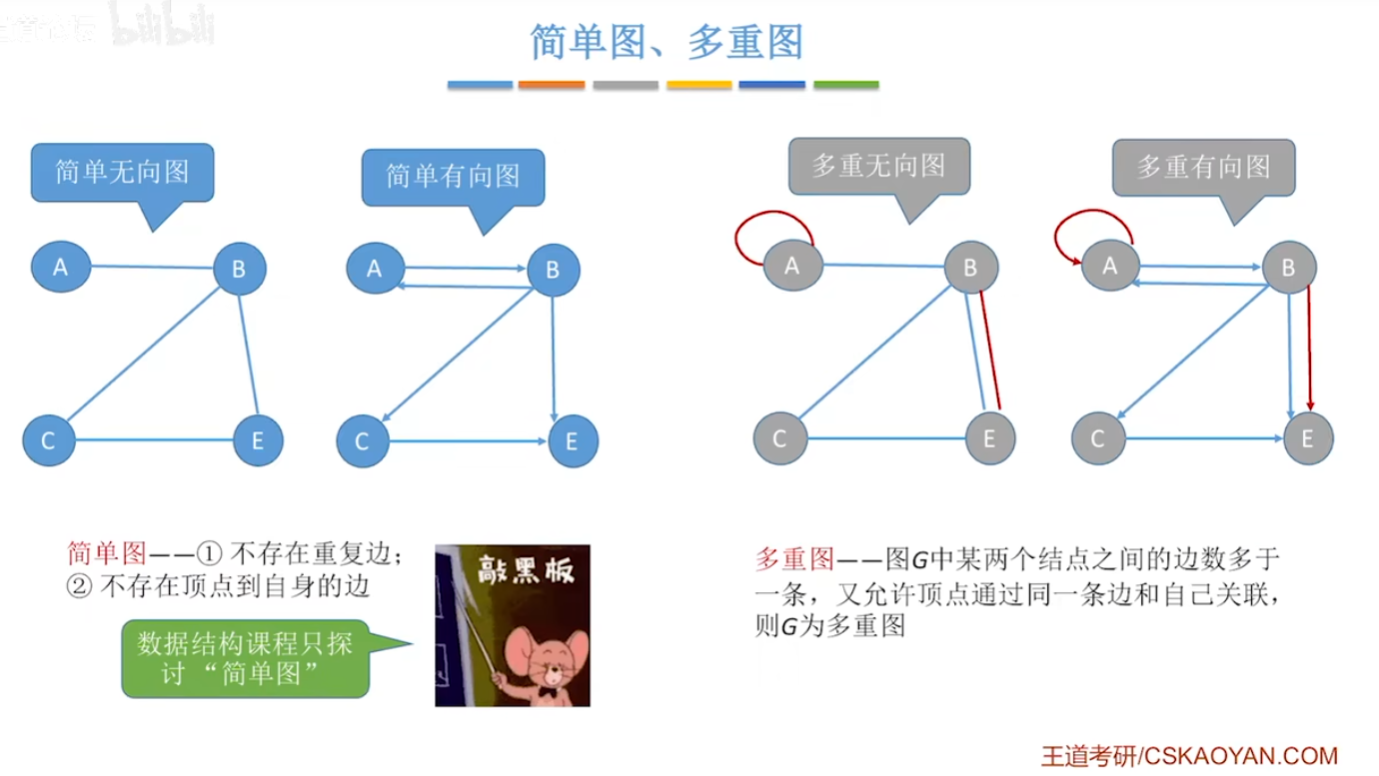
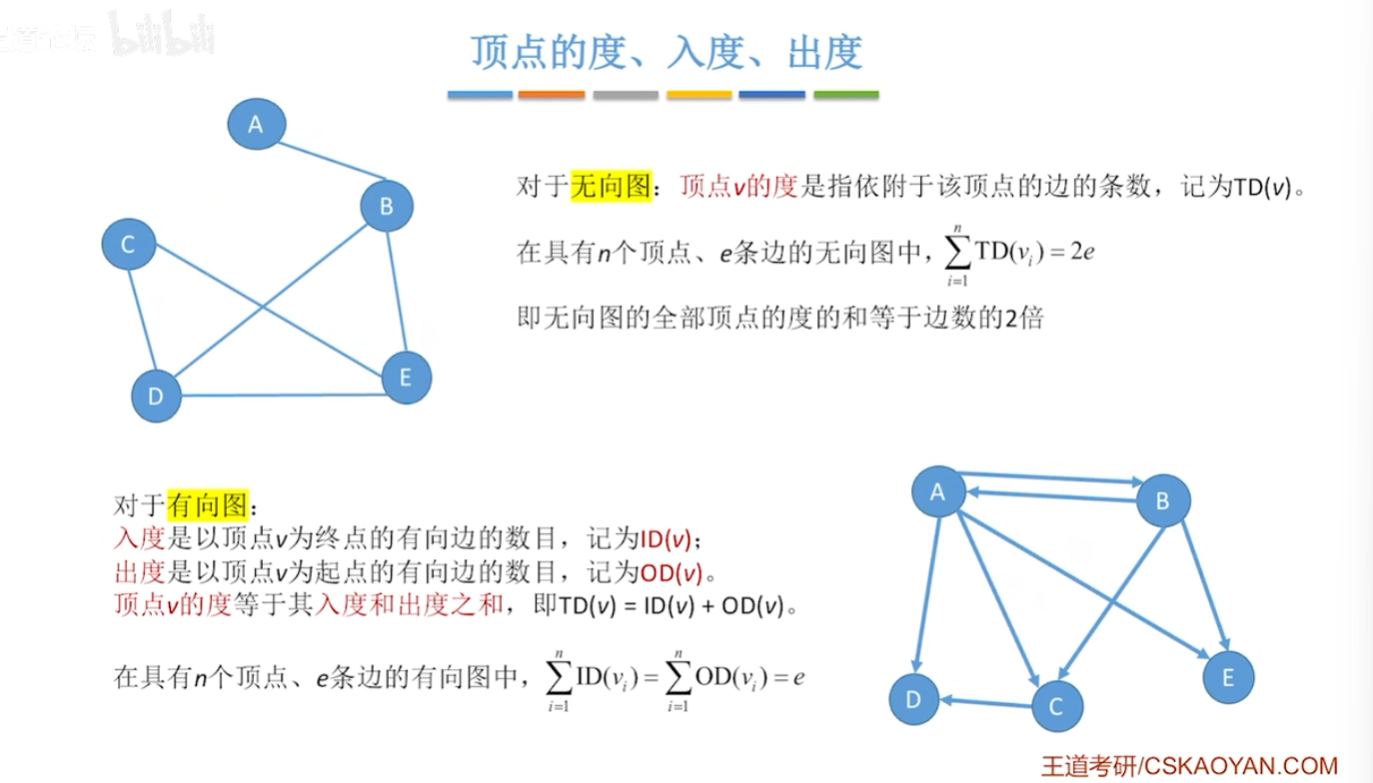
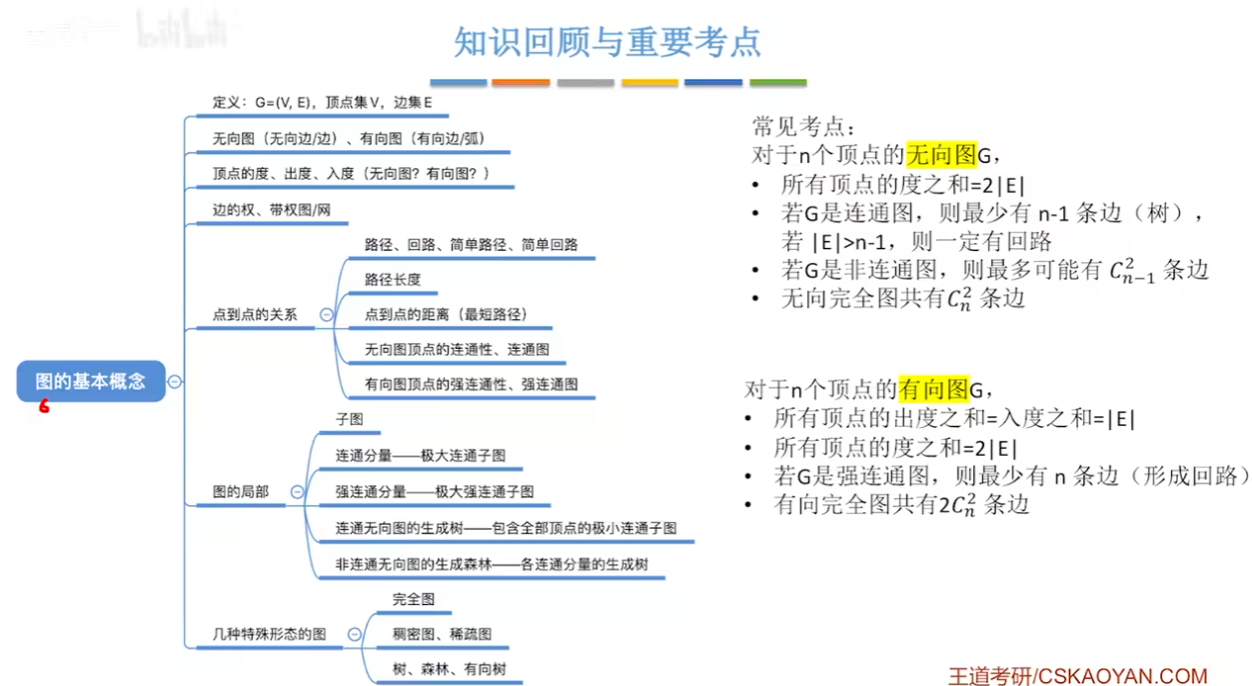
图 \(G\) 由顶点集 \(V\) 和边集 \(E\) 组成,记为 \(G=(V,E)\) 。其中,\(V(G)\) 表示图 \(G\) 中顶点的有限非空集。
存疑,这也许是考研标准,但一般空图也是图
用 \(|V|\) 表示图中 \(G\) 中点的数量。 ,用 \(|E|\) 表示图中 \(G\) 中边的数量。
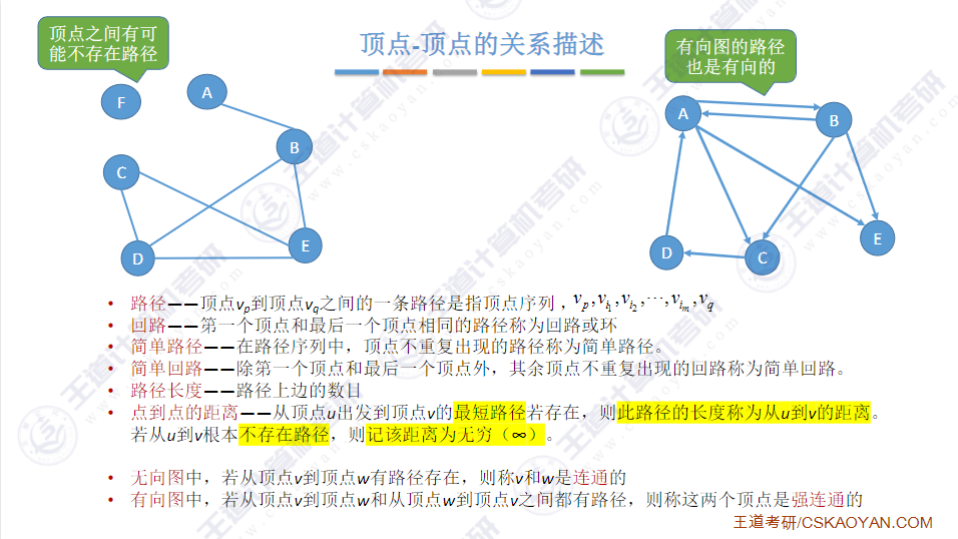

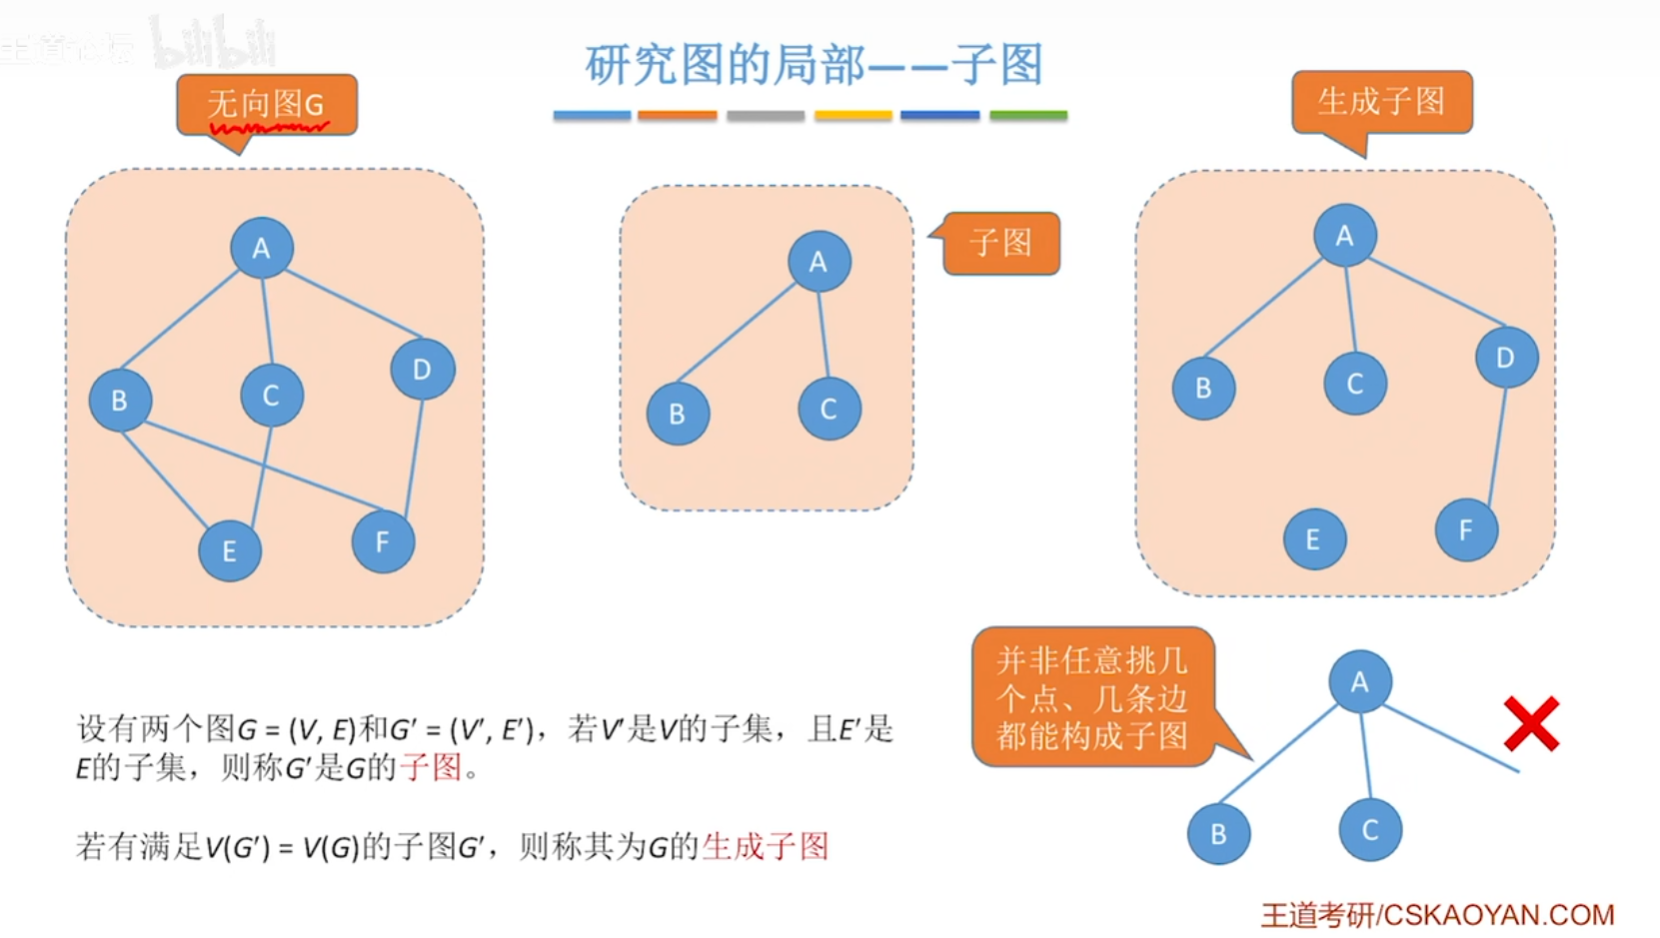
无向图中的极大连通子图称为连通分量
极大连通子图:子图是连通的,而且不存在包含它的连通子图,也就是边和点尽可能多的。
有向图中的极大强连通子图成为有向图的强连通分量
连通图的生成树是包含图中全部顶点的一个极小连通子图
极小连通子图:子图是连通的,而且在相同顶点集,不存在边比它的少连通子图,也就是边尽可能少,但点要尽可能多。
- 无向完全图:无向图中任意两个顶点之间都存在边
- 有向完全图:有向图中任意两个顶点之间都存在方向相反的两条弧
- 边数很少的图称为稀疏图,反之称为稠密图
- 没有绝对的界限,一般来说 \(|E| < |V|\log|V|\) 时,可以将 \(G\) 视为稀疏图
- 树:不存在回路,且连通的无向图
- 有向树:一个顶点的入度为 \(0\)
、其余顶点的入度均为 \(1\)
的有向图,称为有向树
- \(n\) 个顶点的树,必有 \(n-1\) 条边。
- \(n\) 个顶点的图,若 \(|E|>n-1\) ,则一定有回路
图的存储与基本操作
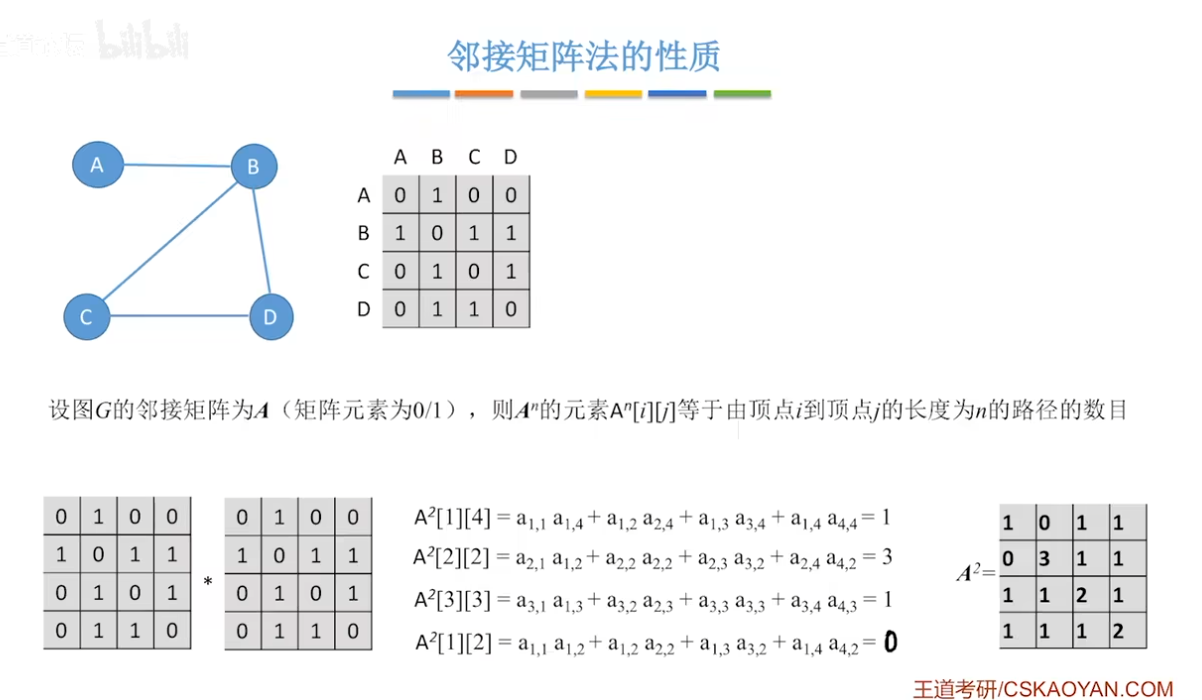
邻接矩阵
使用二维数组存边,其中 \(adj[u][v]=1\) 表示存在 \(u\) 到 \(v\) 的边,为 \(0\) 表示不存在,在带权图中值为边权。
1 |
|
复杂度
查询是否存在某条边:\(O(1)\)。
遍历一个点的所有出边:\(O(n)\)。
遍历整张图:\(O(n^2)\)。
空间复杂度:\(O(n^2)\)。
性质
邻接表
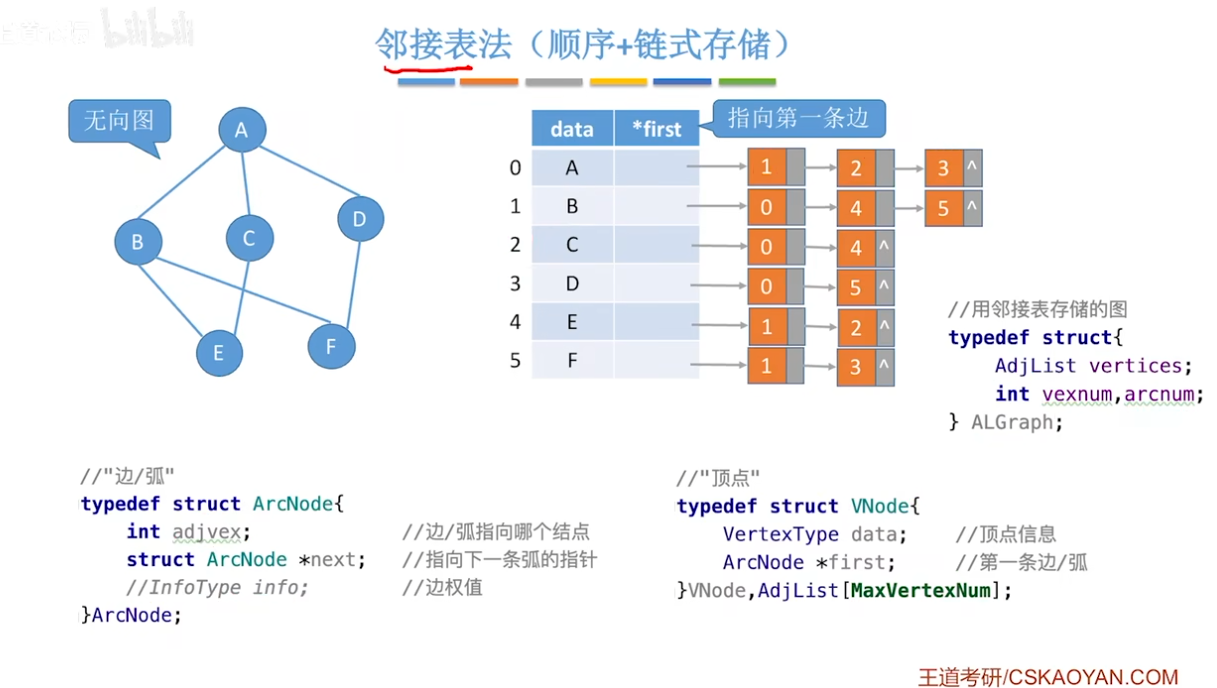
如果要存无向图,注意双向建边。
复杂度
查询是否存在某条边:\(O(d^+(u))\) (如果事先进行了排序可以使用二分查找)
遍历一个点的所有出边:\(O(d^+(u))\)。
遍历整张图:\(O(n+m)\)。
空间复杂度:\(O(m)\)。
十字链表
理解即可
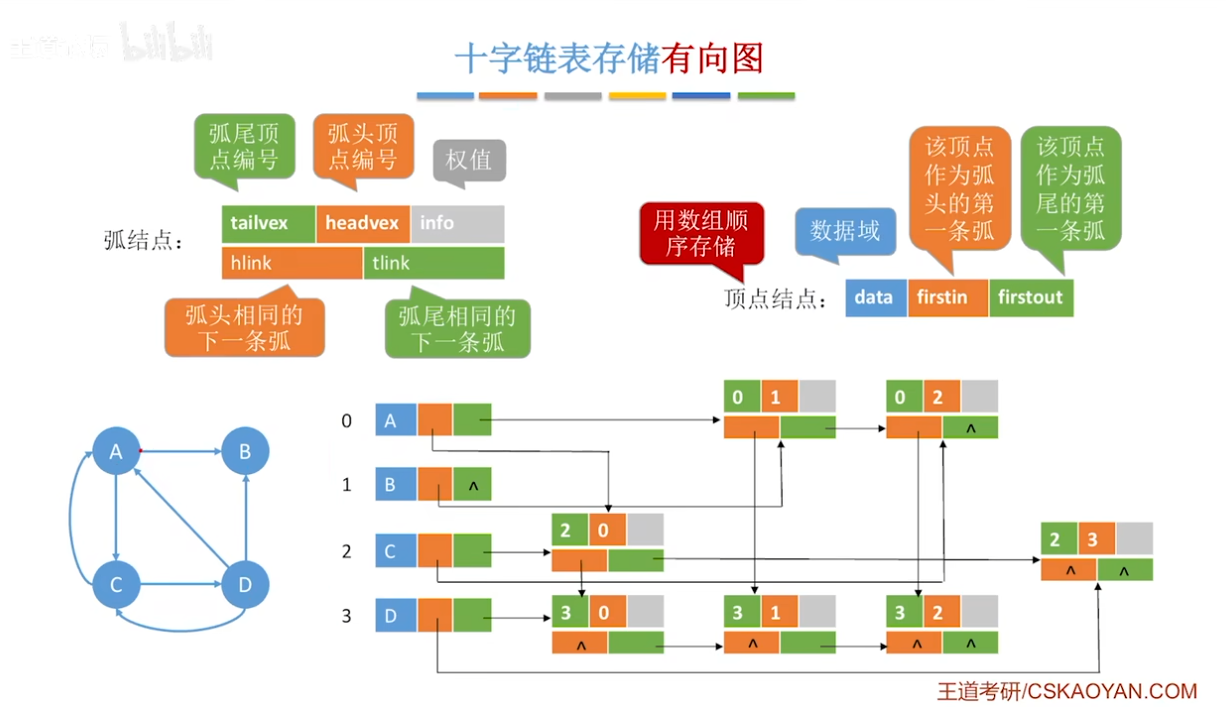
空间复杂度:\(O(|V|+|E|)\)
顺着 绿线 找顶点的出边
顺着 橙线 找顶点的入边
十字链表仅用于存储有向图
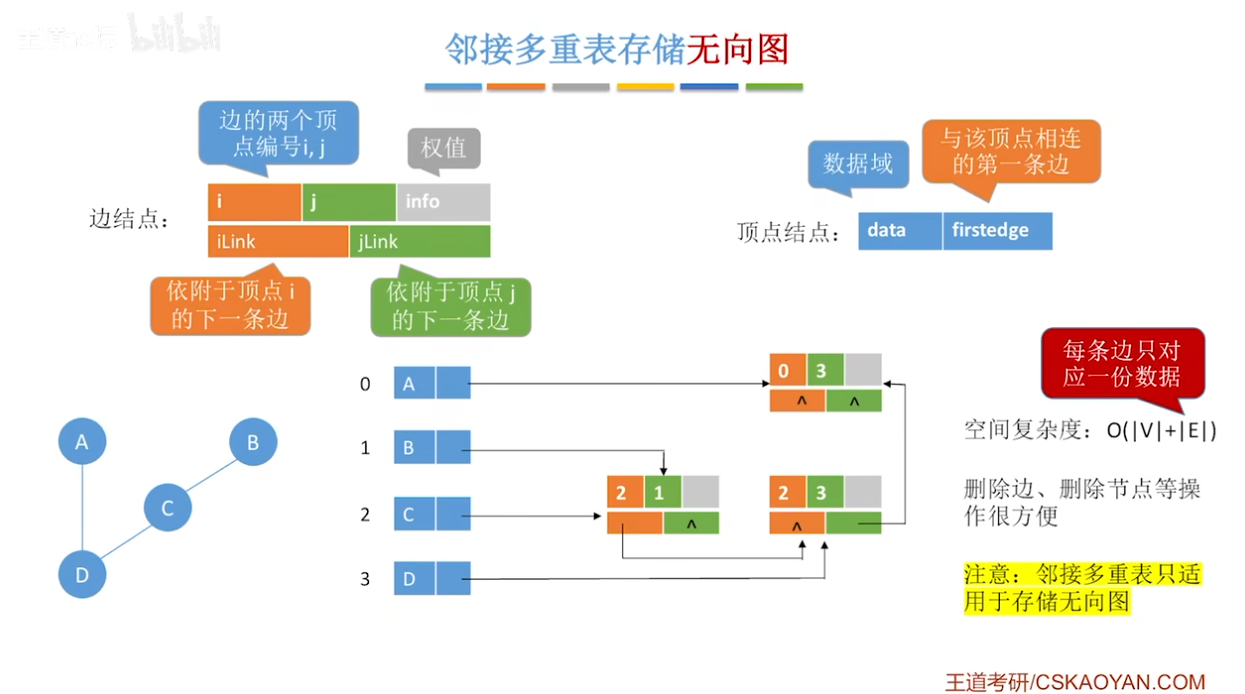
邻接多重表
理解即可
只能存无向图
图的基本操作
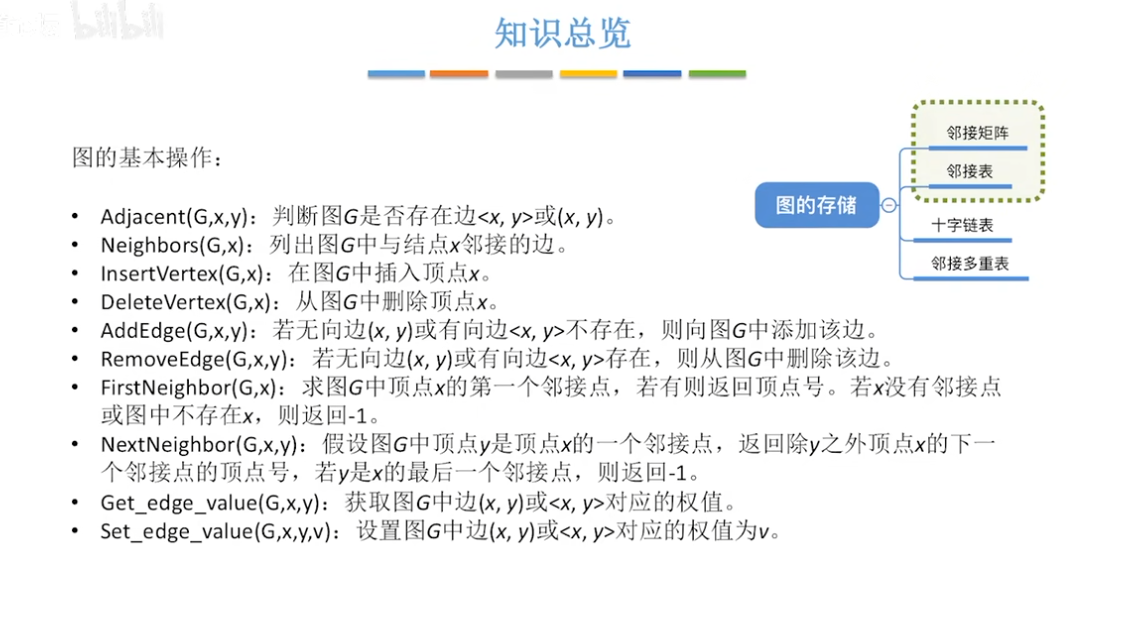
用 \(<x,y>\) 表示有向边,\((x,y)\) 表示无向边
6.3 图的遍历
广度优先遍历
进行 \(BFS\) 的过程建树,即为广度优先生成树,同时,在无向图和有向图中,若权值为1(距离仅是边数),可以用 \(BFS\) 求单源最短路.
1 | bool visited[N]; // 访问标记遍历 |
深度优先遍历
对一个结点进行DFS对应的序列就是一颗深度优先生成树,如果图不止一个连通分量,DFS就是深度优先生成森林。
1 | bool visited[N]; |
6.4 图的应用
最小生成树
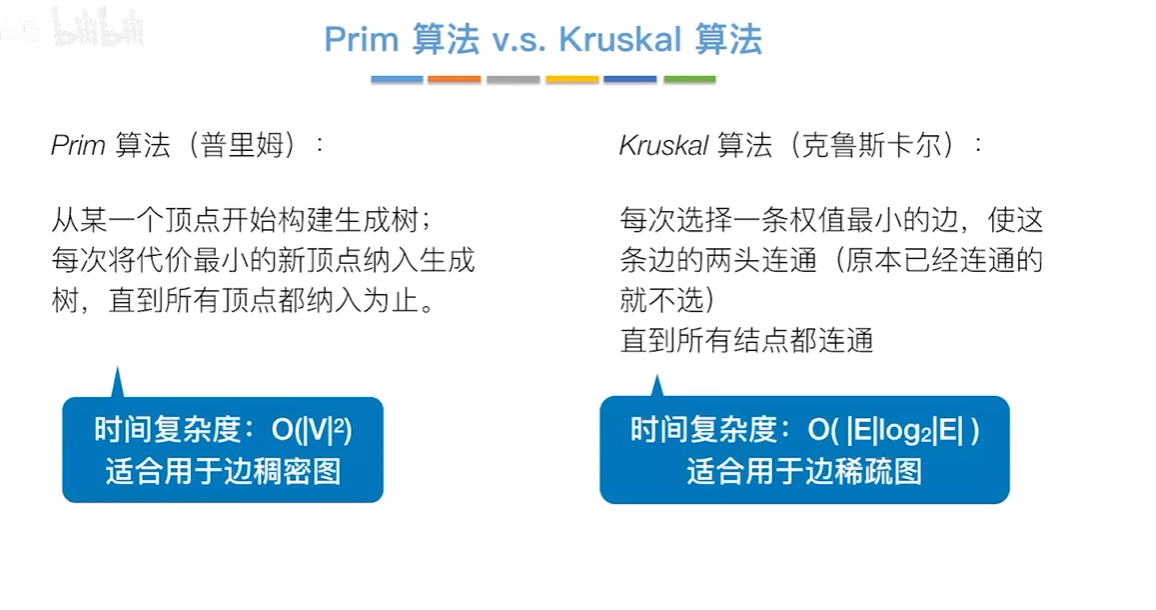
**Prim(普里姆)**算法的思想是,从一个顶点出发,加入集合 \(U\) ,从集合 \(U\) 中的所有顶点中,找出其中离集合最近的顶点 \(v\) ,并将边和顶点均加入集合中,知道所有顶点都被加入集合 \(U\) 为止。
算法简单实现如下:
1 | void Prim(G,T){ |
**Kruskal(克鲁斯卡尔)**算法与 Prim 的方式不同,Kruskal 按照边的权值的递增次序选择合适的边构造最小生成树。
每次考察边的权值,选出最小的,并且当前边连接的两个顶点属于生成树 \(T\) 中不同的连通分量(可通过并查集判断),则将该边加入 \(T\) ;否则,舍弃,直到重复过程满足条件。最后结束时,所有顶点应该同属于一个连通分量。
1 | void Kruskal(V,T){ |
若有兴趣,以上的具体代码可见 最小生成树 - OI Wiki
最短路径
最短路径可以分为两类
- 单源最短路径:从某个顶点 \(v\)
出发,到所有顶点的最短路径
- 可用 Dijkstra(迪杰斯特拉)
- 所有点对间的最短路径,可用**Floyd(弗洛伊德)**求解
拓展:还可了解Bellman-Ford和其优化SPFA(单源)与Johnson(全源)最短路 - OI Wiki
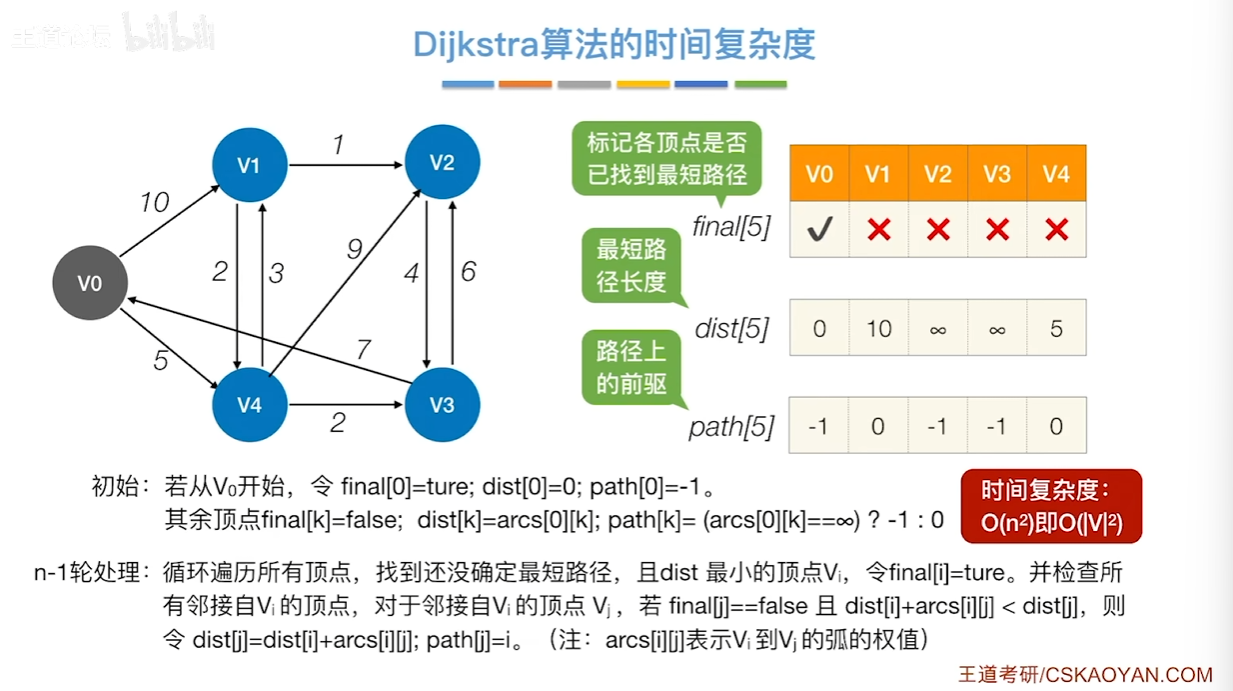
Dijkstra
打过算竟的朋友应该都知道,其能用优先队列优化至 \(O(n\log n)\) ,不过考研不建议炫技
注意:无法用于负权图
从 \(v_0\) 出发,初始所有顶点到 \(v_0\) 的距离 \(dis\) 为无穷大,仅 \(dis[v_0]=0\) ,逐步选择到 \(v_0\) 最短的顶点 \(u\) (第一次显然是 \(v_0\) 本身),这意味着 \(dis[u]\) 的权值是最终最小的,标记 \(vis[u]=1\) ,避免再次选中,并更新 \(v_0\) 到所有**未确定最短路径的顶点(!vis[v])**的最短路径长度 \(dis[v] = min(dis[v],dis[u]+w)\) 。跑完 \(n\) 轮,此时 \(dis[i]\) 一定是到 \(v_0\) 的最短路距离,算法结束。
和王道的不同,但大同小异
1 | struct edge { |
Floyd-Warshall
使用动态规划思想,将问题分解为多个阶段,一般用邻接矩阵。
对第 \(i\) 到 \(j\) 的最短路径 \(f[i][j]\),能否用 \(f[i][k]+f[k][j]\) 求得,即在允许 \(k\) 作为中转站的情况下, 更新能被更新的最短路,一般地,\(k\) 应该从 \(1\) 出发遍历至 \(n\) 。
1 | for (k = 0; k < n; k++) { |
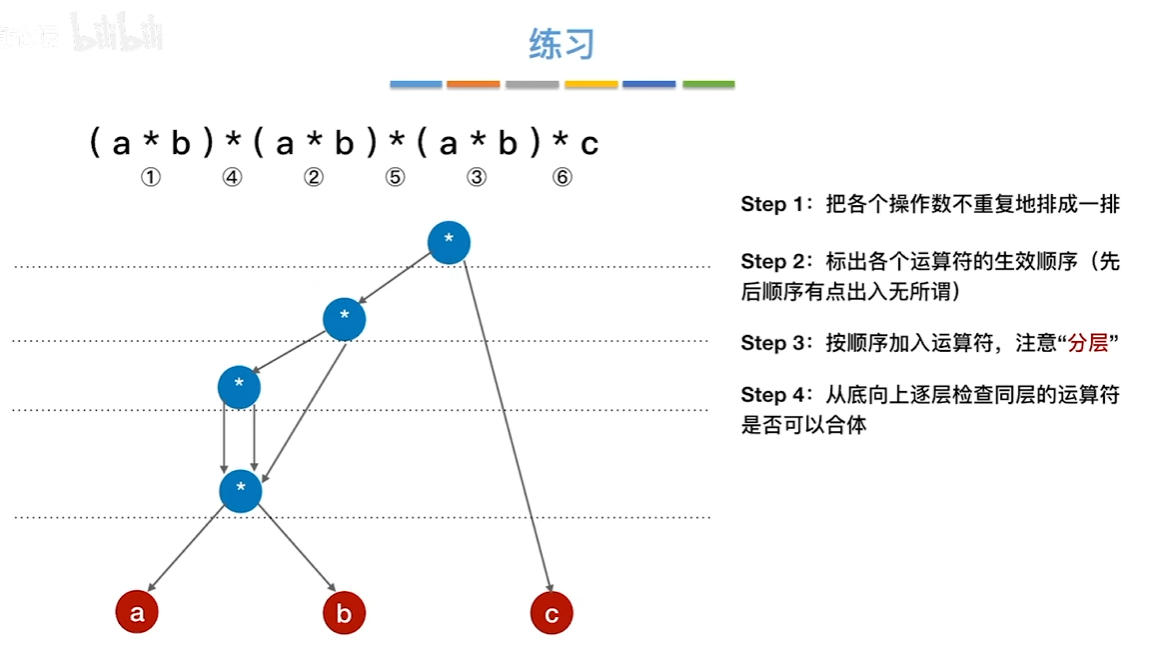
有向无环图描述表达式
一个不存在环的有向图,称为有向无环图(DAG)
拓扑排序
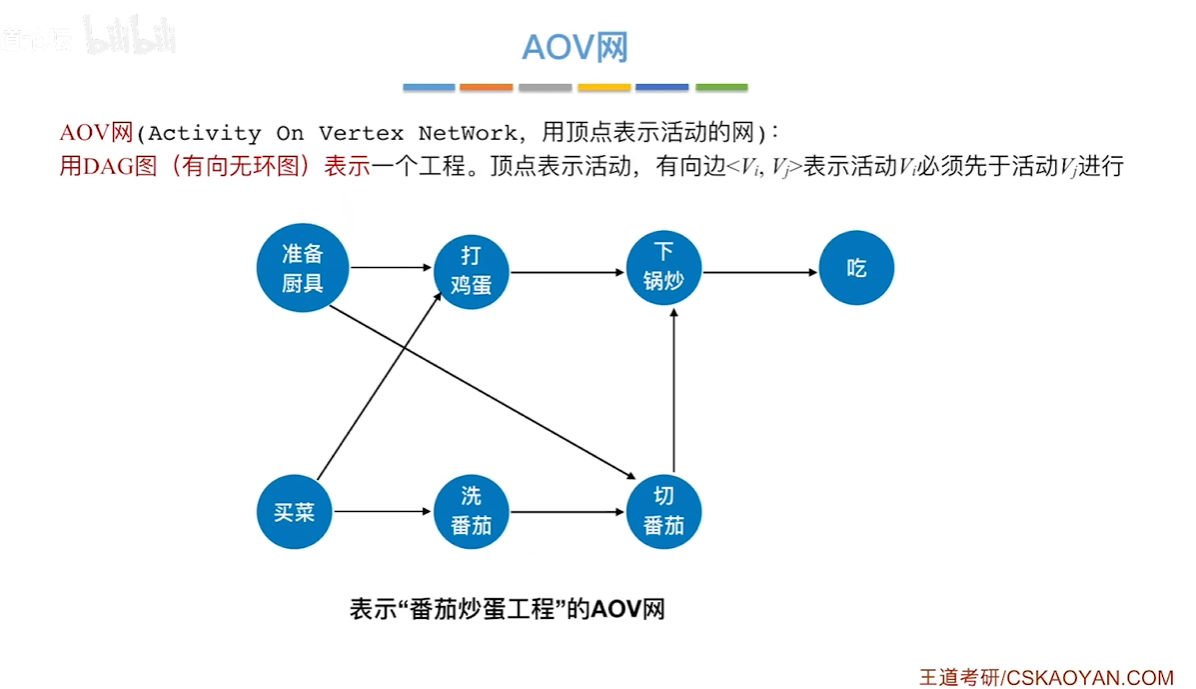
DAG的拓扑排序序列包含所有顶点
拓扑排序:找到一个顺序,满足
- 选择入度为 \(0\) (没有前驱)的结点,输出
- 删除出该点的有向边
- 重复上述步骤,直到不存在入度为 \(0\) 的结点为止。
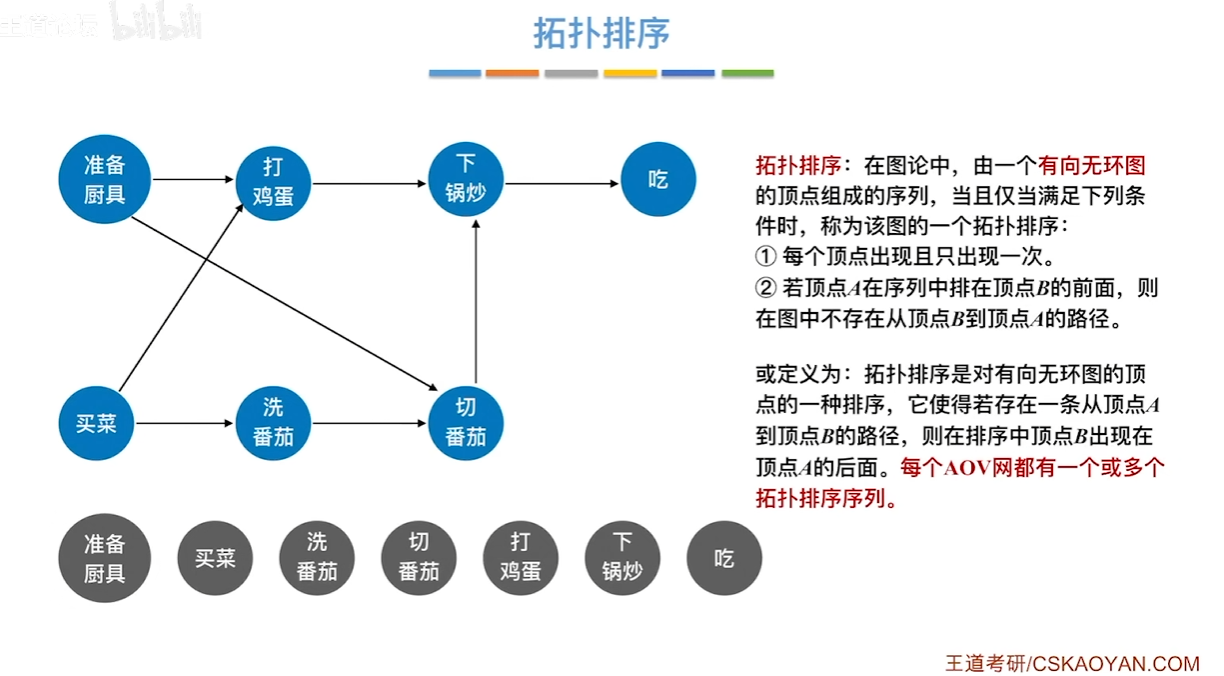
这里给出bfs的实现,dfs的非递归形式可见王道书
1 | int n, m; |
逆拓扑排序,把入度改成出度即可,邻接表可反向建边,输也可以是dfs的后序输出。
关键路径
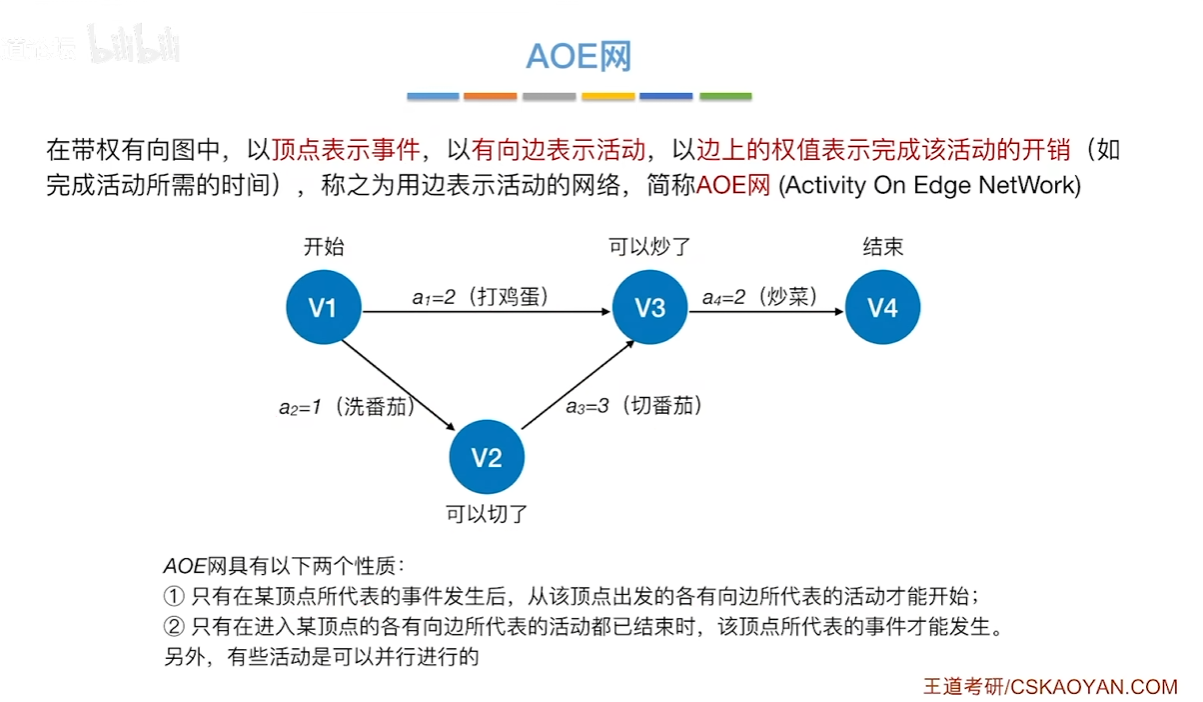
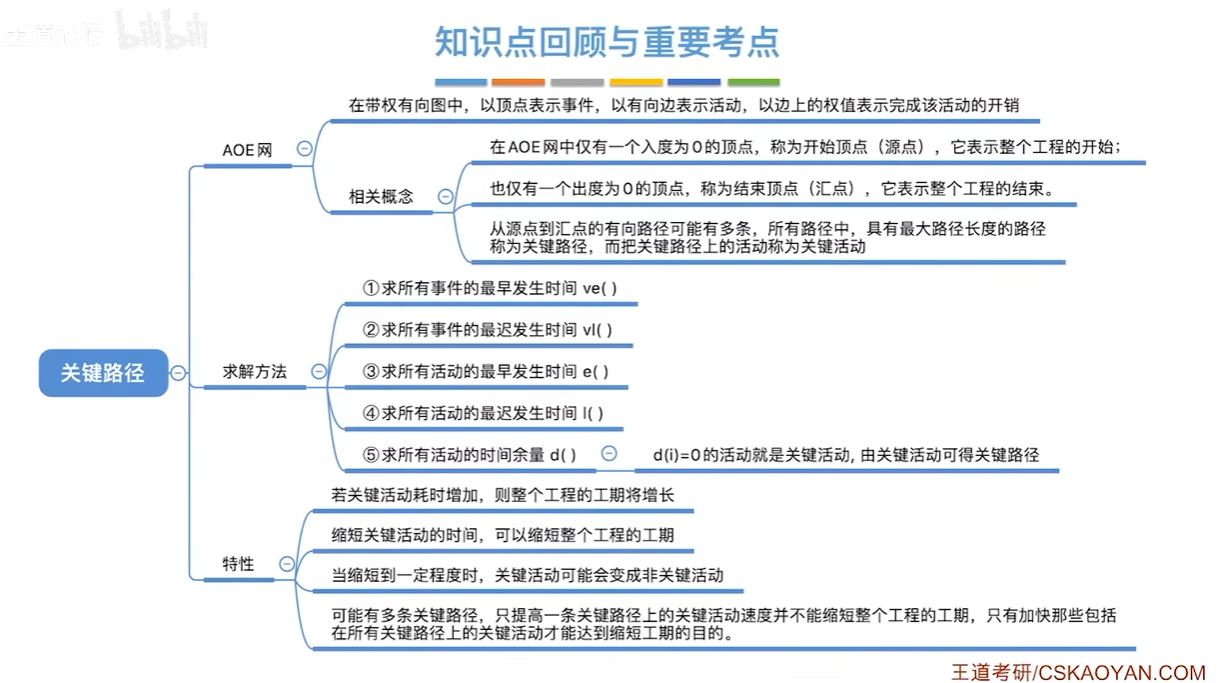
从源点到汇点的有向路径可能有多条,所有路径中,具有最大路径长度的路径称为关键路径,而关键路径上的活动为关键活动。关键路径长度为完成整个工程的最短时间。
- 事件 \(v_k\)的最早发生时间 \(ve(k)\):决定了所有从 \(v_k\) 开始的活动能够开工的最早时间
- 活动 \(a_i\) 的最早开始时间 \(e(i)\):指该活动弧的起点所表示的事件的最早发生时间
- 事件 \(v_k\) 的最迟发生时间 \(vl(k)\) :它是指在不推迟整个工程完成的前提下,该事件最迟必须发生的时间。
- 活动 \(a_i\) 的最迟开始时间 \(l(i)\):它是指该活动弧的终点所表示事件的最迟发生时间与该活动所需时间之差。
- 活动ai的时间余量 \(d(i)=l(i)-e(i)\) ,表示在不增加完成整个工程所需总时间的情况下,活动 \(a_i\) 可以拖延的时间
- 若一个活动的时间余量为零,则说明该活动必须要如期完成,\(d(i)=0\) 即 \(l(i) = e(i)\) 的活动 \(a_i\) 是关键活动
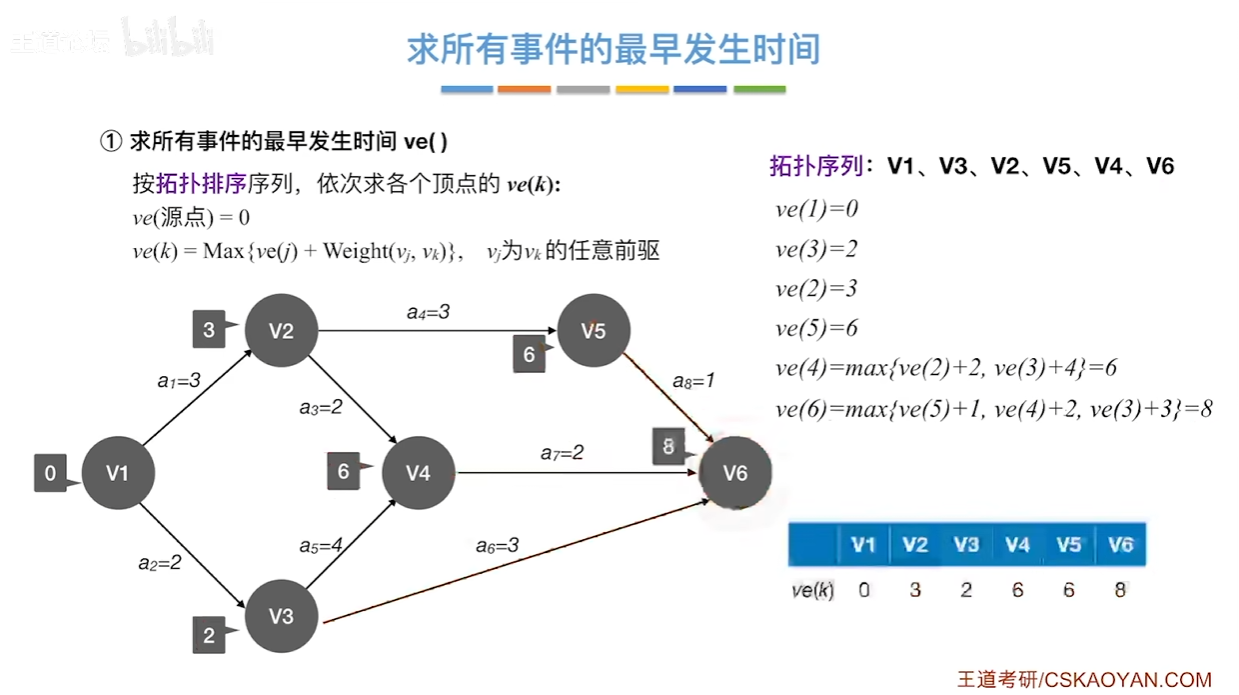
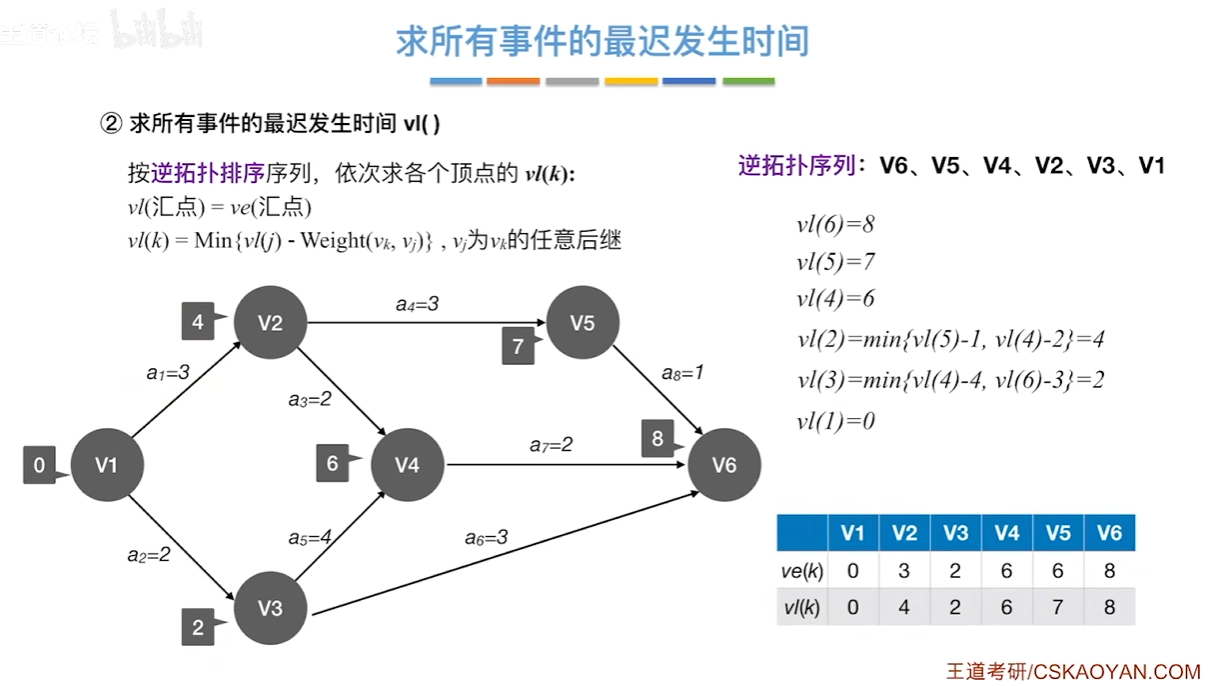
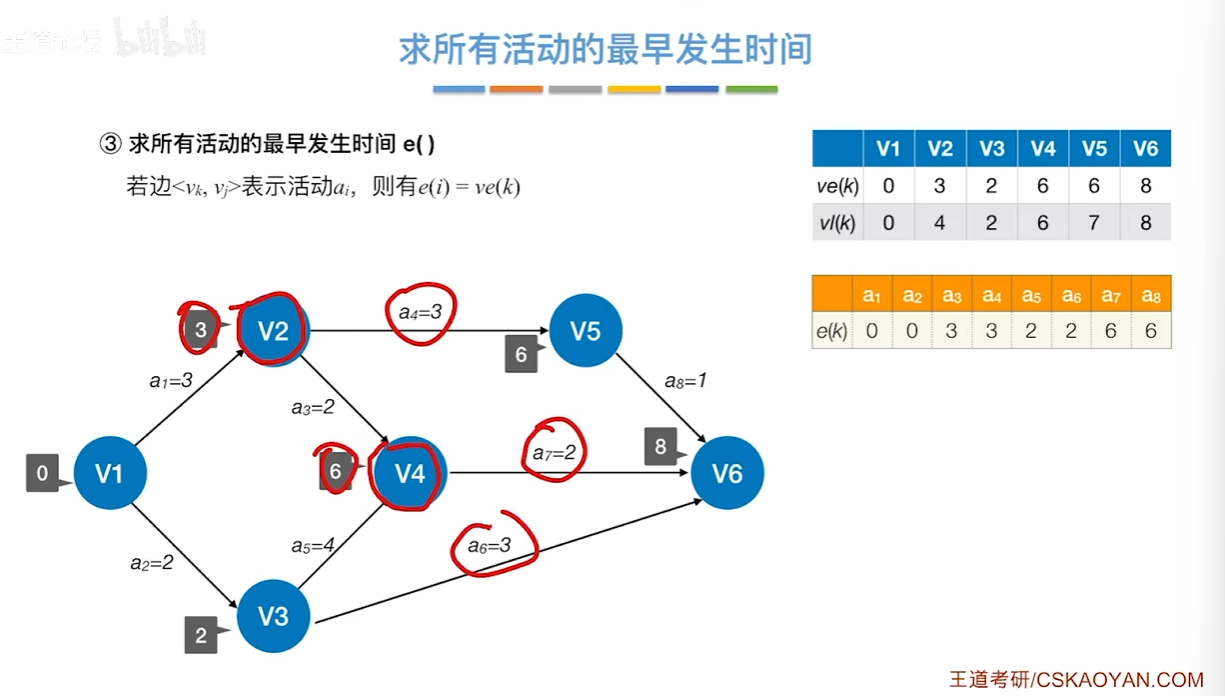
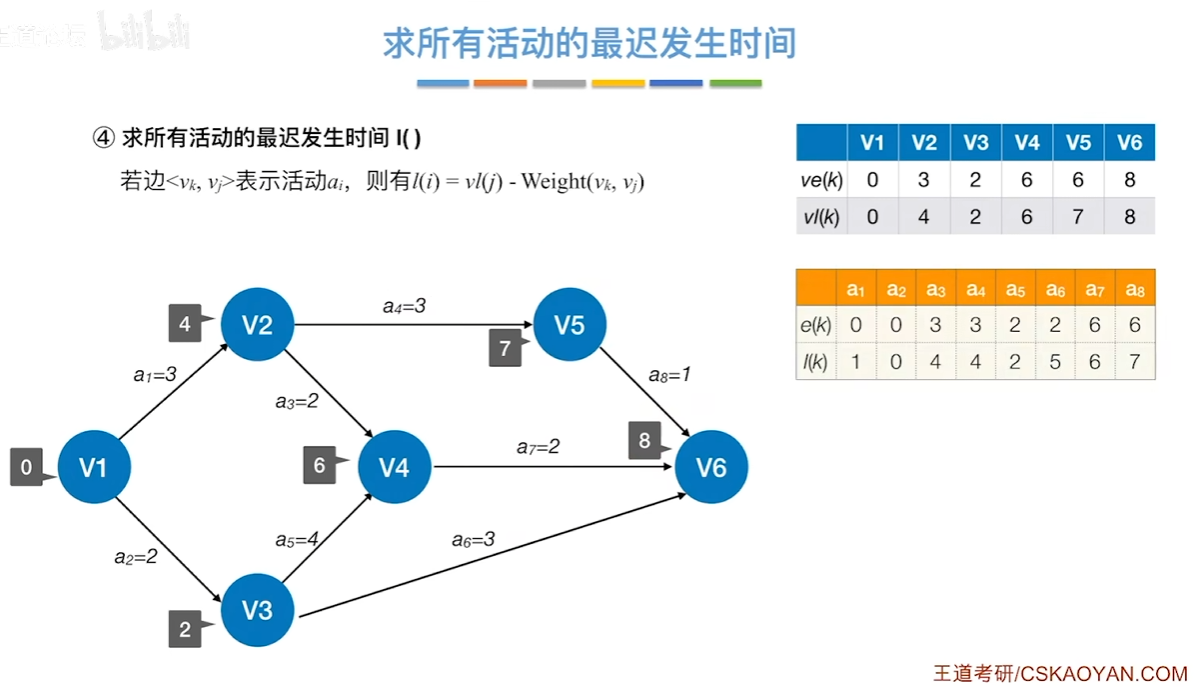
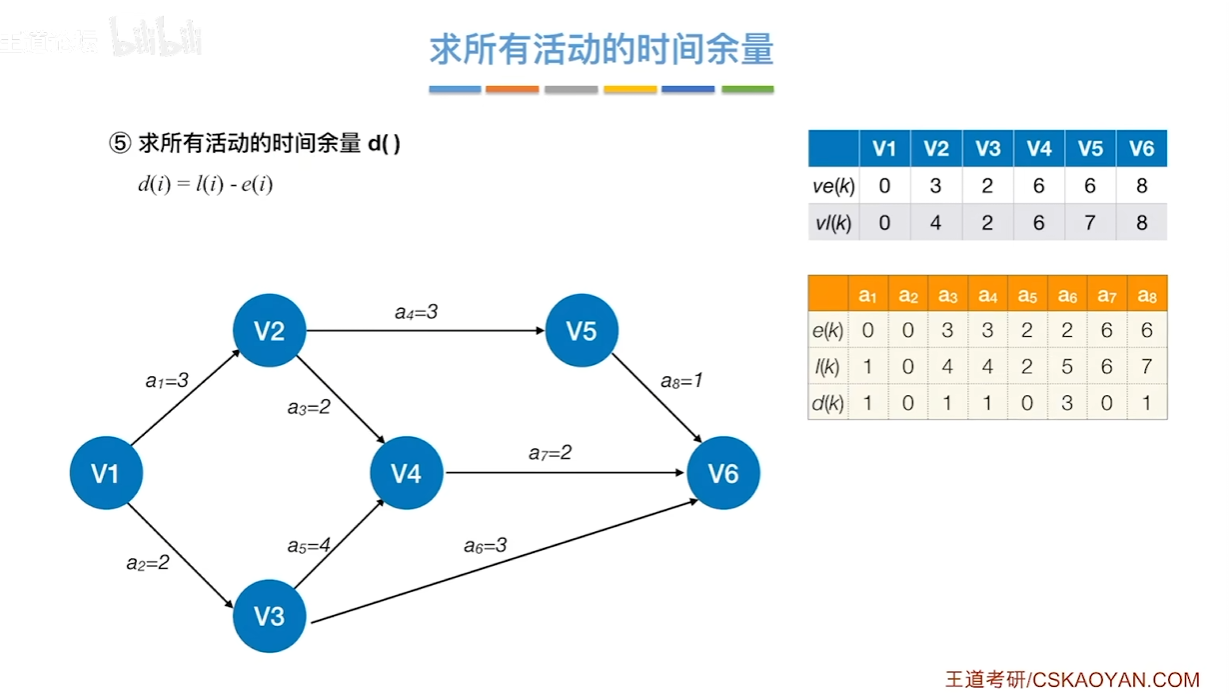
显然,余量为 \(0\) 的为关键活动
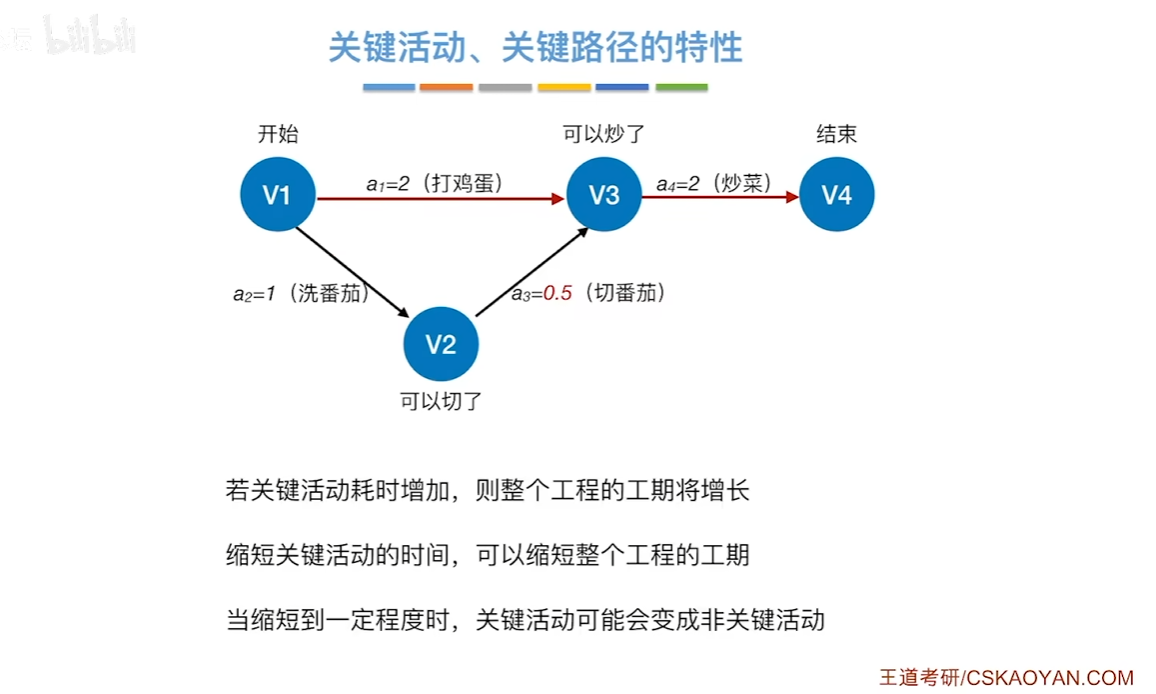
可能有多条关键路径,只提高一条关键路径上的关键活动速度并不能缩短整个工程的工期,只有加快那些包括在所有关键路径上的关键活动才能达到缩短工期的目的。